Une session Claude Code ne ressemble pas à une requête de chat, et un facteur « par requête » ne dit rien d'utile sur elle. Sur une session type, 50 000 tokens d'entrée, 200 000 d'écriture de cache, 3 millions de lecture de cache et 30 000 générés sur Sonnet 5.5, l'équation de la méthodologie donne 134 Wh d'énergie serveur, 50,4 gCO₂e et 797 mL d'eau. Environ 350 mètres en voiture thermique, fabrication comprise. La répartition entre les classes de tokens dit plus que le total : dans un usage agentique, plus de 90 % des tokens traités sont du contexte relu, et ce ne sont pas eux qui pèsent le plus. Ce guide explique le poids d'une session ; pour l'outillage, plugin sur un poste ou lecture de l'usage d'une équipe, voir comment mesurer l'empreinte carbone de Claude Code.
Une session n'est pas une requête
Claude Code empile quatre types de tokens, que le produit compte séparément : l'entrée fraîche, l'écriture de cache, la lecture de cache et la sortie générée. Les proportions n'ont rien à voir avec celles d'une conversation. Sur la trace publique TraceLab (2 676 sessions Claude Code, 37 développeurs, arXiv 2606.30560v2), ramenée à un million de tokens générés, on compte environ 4,8 millions de tokens d'entrée fraîche, 19,3 millions d'écriture de cache et 269,7 millions de lecture de cache. Soit 270 tokens relus du cache pour chaque token généré, et 91,5 % du volume total lu depuis le cache. La même source situe la médiane d'un pas de session à 126 180 tokens.
Un agent fonctionne ainsi : à chaque tour, l'historique et les fichiers ouverts repartent en contexte. Un facteur calibré sur une requête de chat, où l'entrée fait quelques centaines de tokens, ne s'applique pas à une session d'agent.
Où part l'énergie dans une session
Reprenons la session type ci-dessus, décomposée :
| Poste | Volume | Énergie | Part |
|---|---|---|---|
| Entrée fraîche et écriture de cache | 250 000 tokens | 29,8 Wh | 22 % |
| Lecture de cache | 3 000 000 tokens | 28,6 Wh | 21 % |
| Tokens générés | 30 000 tokens | 75,8 Wh | 57 % |
Les 30 000 tokens générés pèsent plus lourd que les 3,25 millions de tokens de contexte réunis. L'écart vient du ratio des facteurs : sur Claude, un token de sortie coûte environ 21 fois l'énergie d'un token d'entrée. Ce ratio est tiré de l'ajustement sur la source primaire. Tant qu'il passe par le cache, un contexte long pèse donc moins qu'on ne le croit.
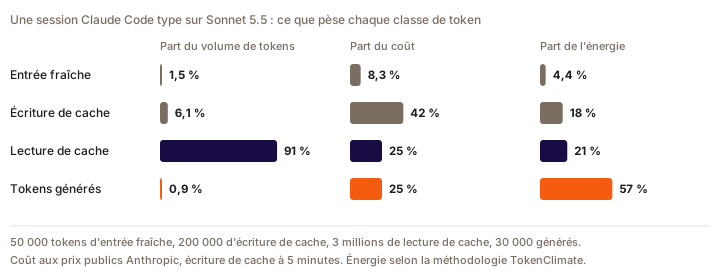
Pour baisser l'empreinte d'une session, le premier levier est donc de réduire les tokens générés inutilement, puisqu'ils portent plus de la moitié de l'énergie. Le contexte pèse le reste, un peu plus de 40 %, et il se réduit aussi, mais chaque token gagné y rapporte beaucoup moins. Côté facture, la colonne du coût montre que les leviers ne sont pas les mêmes : ils sont détaillés dans réduire la facture Claude Code.
Ce que le cache change à l'énergie
Un token relu du cache est un token dont le prefill a déjà été payé. Notre équation lui applique 8 % de l'énergie d'un token d'entrée frais, valeur bornée entre 0,05 et 0,20 dans la méthodologie. Ce facteur est indépendant du ratio de facturation d'Anthropic, qui reste un prix.
Ce terme couvre le résidu de prefill. La relecture du cache pendant le décodage est un autre coût : chaque token généré relit l'intégralité du cache depuis la mémoire, ce que la littérature documente (GreenCache, SIGMETRICS). Ce coût est aujourd'hui absorbé dans un facteur de sortie supposé constant, calibré sur des contextes vraisemblablement courts. En régime de contexte long, donc en usage agentique, notre chiffre sous-estime ce poste. Pour le corriger, il faudra ajouter à l'équation un terme qui dépend de la longueur du contexte.
Le choix du modèle pèse plus que le volume
Les facteurs d'énergie de la gamme Claude s'étalent sur un facteur seize, de Haiku à Fable. La session type ci-dessus, à volumes strictement identiques, donne 13 gCO₂e sur Haiku, 50 sur Sonnet, 101 sur Opus et 202 sur Fable. Un routage par défaut vers le modèle le plus lourd multiplie donc l'empreinte d'une équipe sans que personne n'écrive une ligne de plus. La répartition réelle de vos tokens par modèle est le premier chiffre à sortir, avant toute discussion sur les volumes. Les facteurs par famille et leurs niveaux de confiance sont détaillés dans l'empreinte carbone de Claude.
FAQ
Combien de CO₂e pour une session Claude Code ?
Environ 50 gCO₂e pour une session Sonnet 5.5 de 30 000 tokens générés avec 3,25 millions de tokens de contexte, avec les facteurs de notre méthodologie. La même session sur Opus double le chiffre, sur Haiku le divise par quatre. Un chiffre par session n'a de sens qu'accompagné du modèle et des volumes des quatre classes de tokens.
Le cache réduit-il l'empreinte carbone ?
Oui, sans l'annuler. Un token relu compte pour 8 % de l'énergie d'un token d'entrée frais dans notre équation. Et cette valeur ne couvre que le prefill évité : la relecture du cache pendant la génération reste payée, absorbée aujourd'hui dans le facteur de sortie, ce qui nous fait sous-estimer les très longs contextes.
Pourquoi mon chiffre diffère-t-il de celui d'un collègue à usage comparable ?
Presque toujours à cause du mix de modèles, ensuite à cause du ratio entre tokens générés et contexte relu. Deux personnes qui écrivent le même nombre de lignes mais l'une sur Opus et l'autre sur Haiku sont séparées par un facteur huit, à volumes identiques.
Faut-il compter les sessions reprises ou compactées ?
Une seule fois. Un transcript rejoue les messages précédents quand la session reprend ou se compacte, et une somme brute sur-compte d'environ trois fois. Tout outil sérieux déduplique par identifiant de message avant de sommer ; si le vôtre ne le documente pas, vérifiez-le avant de publier un chiffre.
Sources
- Méthodologie TokenClimate : équation, facteurs par famille et traitement du cache
- TraceLab, trace publique de sessions Claude Code, arXiv 2606.30560v2
- GreenCache, énergie du KV cache en phase de décodage, arXiv 2505.23970
- Irminsul, mesure directe du rapport hit/miss de prefill, arXiv 2605.05696
- Impact CO₂ (ADEME), 142 gCO₂e par kilomètre pour une voiture thermique, fabrication comprise