Calculateur coût et empreinte
Décrivez votre mix de modèles, l'impact s'affiche aussitôt.
Aucun contexte estimé : seuls les tokens de sortie comptent.
Passer à ce scénario : 0 % de CO₂e, 0 % de coût.
Confiance faible ou inconnue sur le facteur CO₂ de : GPT-6.1 Sol, GPT-6.2 Sol. Chiffres à interpréter avec prudence.
Résultat du scénario
CO₂e / mois
6,7 kg
de 4,5 kg à 8,7 kg
Coût / mois
87 €
Soit environ 47 km en voiture thermique et 1 douche sur ce volume mensuel.
Confiance faible sur le facteur CO₂ de GPT-6.1 Sol : chiffres à interpréter avec prudence.
Énergie / mois
15,2 kWh
Eau / mois
78,4 L
Eau : dont 5,8 % de refroidissement, le reste pour produire l'électricité.
Tokens traités sur ce profil
- Lecture de cache0 %
- Écriture de cache0 %
- Entrée0 %
- Sortie100 %
Ces chiffres sont des estimations, aux tarifs publics des fournisseurs. S'ils vous paraissent vraiment faux, écrivez à gaetan@tokenclimate.com.
Profil « Sortie seule » : seuls les tokens de sortie sont comptés. En usage agentique, le contexte et le cache font l'essentiel du volume : choisissez un profil pour les estimer. Le dashboard mesure ce ratio sur les volumes de votre organisation, relevés chaque jour.
52 modèles couverts, chacun avec sa fiche et son niveau de confiance : tous les modèles.
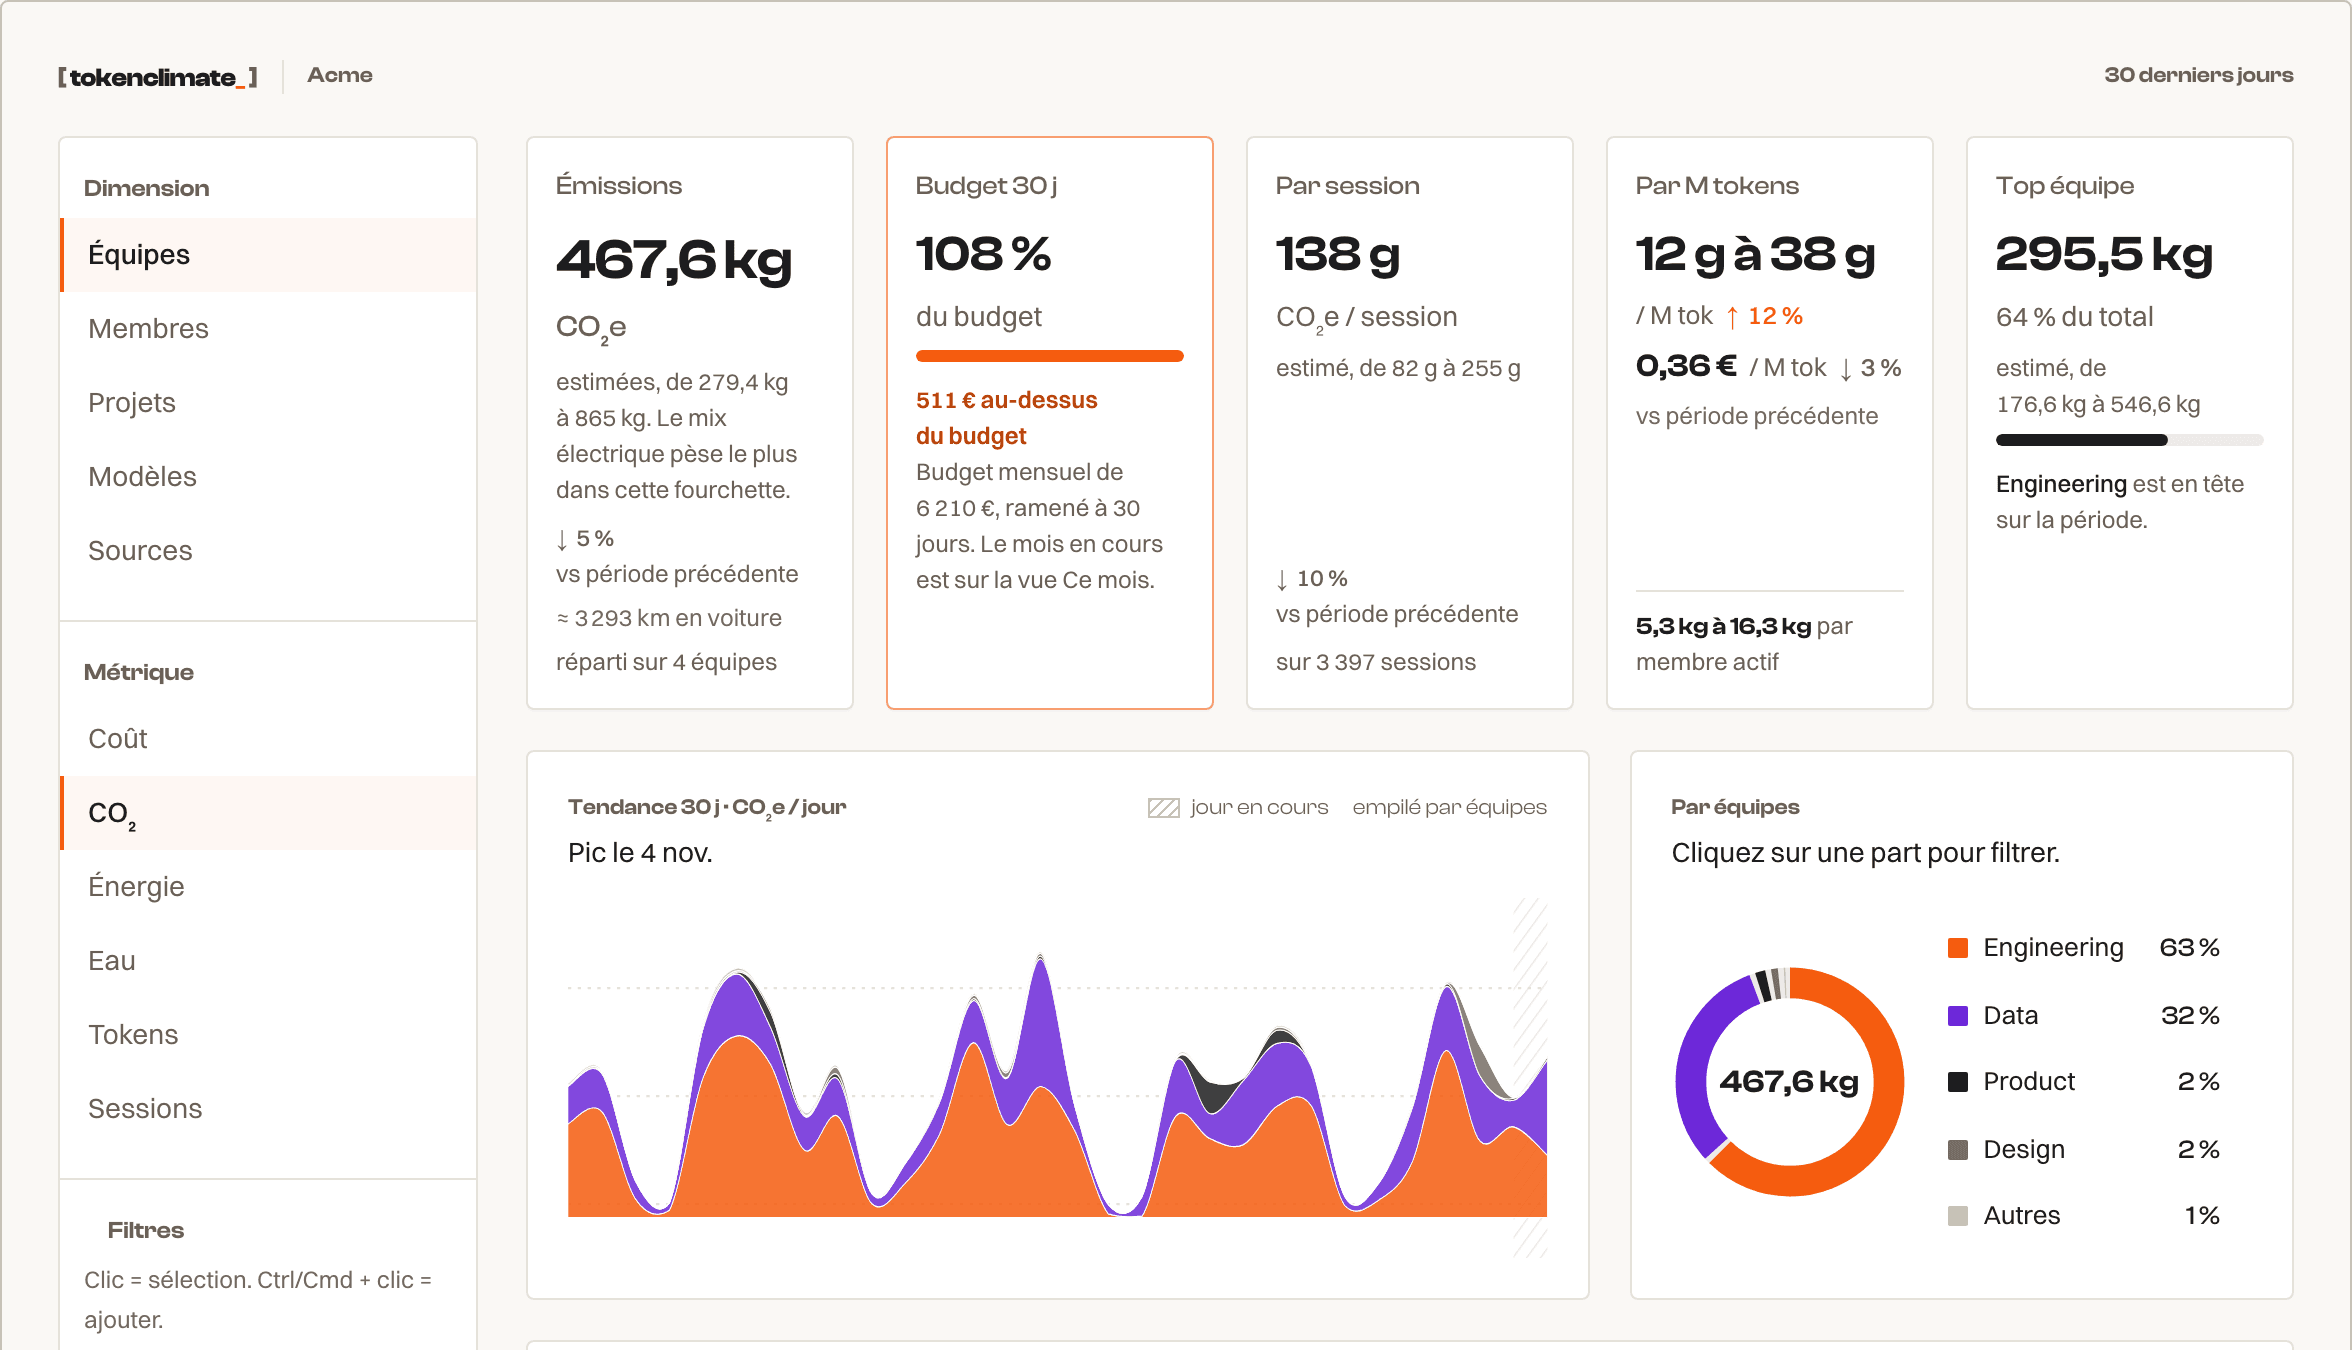
Suivre ces chiffres chaque mois, sans les saisir
Le dashboard récupère ces volumes tout seul, depuis vos clés d'administration Anthropic, OpenAI ou OpenRouter, et les répartit par équipe et par personne. On l'installe avec vous après un échange de 30 minutes.
Questions fréquentes
- Que compte exactement le calculateur ?
- Les quatre classes de tokens facturées par les fournisseurs : entrée, écriture de cache, lecture de cache et sortie. Le périmètre est celui de la méthodologie TokenClimate : datacenter tiers, inférence seule, en location-based par défaut. Chaque facteur d'énergie est sourcé et versionné, la méthodologie complète est publique.
- Pourquoi les tokens de sortie ne suffisent-ils pas ?
- Parce qu'en usage agentique ils ne sont qu'une petite partie de ce que la machine traite. Sur le profil agent de code, environ 91 % des tokens traités sont des lectures de cache. Une lecture de cache coûte environ 0,08 fois l'énergie d'un token d'entrée (voir la section « Énergie du cache » de la méthodologie) : c'est peu par token, mais le volume en fait un terme significatif du total.
- D'où viennent les ratios des profils d'usage ?
- Chaque profil est un jeu de volumes de référence sourcé et versionné, affiché à l'écran avec son hypothèse. Le profil chat s'appuie sur la médiane d'une trace de production conversationnelle (Splitwise, ISCA 2024). Le profil agent de code est recopié des agrégats mesurés par TraceLab sur 2 676 sessions Claude Code réelles, 37 développeurs d'un même laboratoire. Le ratio réel varie d'une organisation à l'autre : le dashboard le mesure sur vos données réelles.
- Je ne connais pas mon volume de tokens, comment faire ?
- Personne ne le connaît de tête, et le mode simplifié existe pour ça. Il pose trois questions, ce que vous déléguez à l'outil, combien de personnes l'utilisent et à quelle cadence, puis en déduit un volume mensuel que vous pouvez corriger dans le champ. Les tokens par session (96 900 000 / 2 676, TraceLab) et par échange (150, Splitwise) sont dérivés de sources publiées ; la cadence, elle, n'est pas devinée, vous la saisissez. Pour vous situer, la méthodologie publie celle que TraceLab a mesurée : 1,9 session par développeur et par semaine, soit 8,0 par mois. Le résultat est un ordre de grandeur arrondi à deux chiffres significatifs, pas une mesure.
- Peut-on partager ou citer un scénario ?
- Oui. L'URL encode les modèles, leurs volumes et le profil d'usage, rien d'autre. Les chiffres sont recalculés à chaque ouverture avec la version courante de la méthodologie, côté serveur pour les emails. Un scénario cité reste donc vérifiable et recalculable.