L'inférence pèse le plus dès qu'un modèle est largement déployé, une fois additionné ce que coûte chaque token servi. Mais le point de bascule dépend de l'exploitation du modèle, pas de sa taille : il faut entre 861 millions et 276 milliards de requêtes pour que l'inférence rattrape l'entraînement, selon le modèle et le remplissage des serveurs.
Sur un même modèle, passer d'un service saturé à un service à une requête par seconde déplace ce seuil d'un facteur 30. Et le chiffre d'entraînement que vous lisez ne couvre qu'environ 10 à 23 % (9,6 à 22,6 %) du calcul qui a réellement produit le modèle, sur les trois seuls laboratoires qui publient la part de leur run final.
Ce que couvre le chiffre d'entraînement publié
Presque toujours le seul run retenu, jamais le projet. DeepSeek le pose lui-même dans son rapport technique V3 : « Note that the aforementioned costs include only the official training of DeepSeek-V3, excluding the costs associated with prior research and ablation experiments on architectures, algorithms, or data. »
C'est le dernier entraînement, celui dont sortent les poids publiés. Il est précédé de centaines d'essais : ablations, lois d'échelle, balayages d'hyperparamètres, runs abandonnés en cours de route.
Pour un bilan carbone, c'est un numérateur incomplet : deux mesures indépendantes, l'une en dollars de calcul, l'autre en tonnes, convergent vers un coût réel 1,5 à 10 fois plus élevé.
Denain et Wu (Epoch AI, 23 mars 2026) mesurent la part du run final dans le calcul de R&D, en dollars :
| Laboratoire | Période | Part du run final |
|---|---|---|
| OpenAI | 2024 | environ 9,6 % |
| Z.ai | S2 2024 à S1 2025 | 12,3 % |
| MiniMax | T4 2024 à T3 2025 | 22,6 % |
Morrison et al. (ICLR 2025, arXiv:2503.05804) arrivent au même ordre de grandeur par une autre voie, en publiant les 813 runs de développement d'OLMo 2, chose que personne d'autre ne fait.
| Poste, cycle complet d'OLMo 2 | tCO2eq |
|---|---|
| Fabrication du matériel, amortie sur 4 ans | 22 |
| Développement, 813 runs | 159 |
| Runs d'entraînement finaux | 312 |
| Total | 493 |
Verbatim de leur résumé : « model development, the impact of which is generally not disclosed by most model developers, amounted to ~50% of that of training ».
Emma Strubell monte plus haut encore, avec Jacob Morrison et Noah A. Smith (The Hidden Cost of Thinking, arXiv:2605.01158, mai 2026) : le développement, c'est-à-dire les essais, les runs ratés et les ablations, pèse 82,2 % du calcul total, soit un facteur 5,6 de sous-estimation quand on ne compte que le modèle final. Elle a repris ces chiffres en conférence à la journée ENS/OBVIA du 9 juin 2026. L'ordre de grandeur recoupe celui d'Epoch AI par une autre méthode.
Les empreintes déclarées sont des planchers
Les model cards de Meta sont les seules à publier les deux conventions comptables côte à côte. Périmètre : run de pré-entraînement final seul, heures de calcul multipliées par la puissance de pointe de chaque GPU, que Meta dit « ajustée » pour l'efficacité du bâtiment sans publier le PUE retenu, sans processeur hôte, réseau ni matériel.
| Modèle | Heures GPU | Location-based | Market-based |
|---|---|---|---|
| Llama 2, total | 3 311 616 (A100) | 539 tCO2eq | non publié |
| Llama 3, total | 7,7 M (H100) | 2 290 tCO2eq | non publié |
| Llama 3.1, total | 39,3 M (H100) | 11 390 tCO2eq | 0 |
| Llama 3.3 70B | 7,0 M | 2 040 tCO2eq | 0 |
| Llama 4, Scout et Maverick | 7,38 M | 1 999 tCO2eq | 0 |
Le zéro vient d'une phrase identique sur toutes les cartes depuis juillet 2024 : Meta couvre 100 % de sa consommation par des achats d'énergie renouvelable. Le chapitre market-based contre location-based revient sur ce que cette convention mesure.
Le chiffre location-based, lui, est vérifiable par division. 39,3 millions d'heures multipliées par 0,7 kW donnent 27 510 MWh, et 11 390 tonnes rapportées à cette énergie donnent 0,414 kgCO2e/kWh, un facteur proche de la moyenne du réseau américain. Le calcul se reproduit sur toutes les générations, entre 0,387 et 0,425 : la méthode est auditable.
Reste que ce chiffre exclut le processeur hôte et la fabrication du matériel, et que le rendement du bâtiment n'y entre que par un ajustement non publié. Il constitue donc lui aussi un plancher.
Le carbone est dans le réseau électrique, pas dans le modèle
La démonstration la plus nette vient du papier BLOOM (Luccioni, Viguier et Ligozat, JMLR vol. 24, 2023, tableau 4). Périmètre : consommation dynamique du run final, hors rendement du bâtiment.
| Modèle | Paramètres | Intensité du réseau | Énergie | CO2e |
|---|---|---|---|---|
| GPT-3 | 175 B | 429 gCO2eq/kWh | 1 287 MWh | 502 t |
| Gopher | 280 B | 330 gCO2eq/kWh | 1 066 MWh | 352 t |
| OPT | 175 B | 231 gCO2eq/kWh | 324 MWh | 70 t |
| BLOOM | 176 B | 57 gCO2eq/kWh | 433 MWh | 25 t |
Multipliez l'intensité par l'énergie et vous retrouvez la dernière colonne sur Gopher et BLOOM. GPT-3 s'en écarte parce que Patterson et al. intègrent le rendement du bâtiment dans leur énergie, les autres non. OPT ne tombe pas juste non plus : 324 MWh à 231 g donnent 74,8 t, contre 70 t publiées dans le tableau du papier BLOOM. Le papier publie aussi une colonne avec ce rendement appliqué partout, où les quatre valeurs deviennent 552, 380, 76,3 et 30 tonnes. Deux colonnes, deux périmètres, et c'est le genre d'écart qu'un tableau composite fait disparaître.
BLOOM consomme plus d'énergie qu'OPT à taille comparable, 433 MWh contre 324, et émet 2,8 fois moins. Le facteur discriminant est le réseau électrique du lieu d'entraînement.
Le même papier isole un poste que personne d'autre ne mesure. Sur le cycle de vie complet de l'entraînement de BLOOM, 22,2 % viennent de la fabrication du matériel, 48,9 % de la consommation dynamique et 28,9 % de la consommation à vide, c'est-à-dire de l'attente.
Le seuil de bascule, chiffré
Tableau 3 de Morrison et al. Protocole : 2 400 prompts ShareGPT servis via SGLang sur un H100, facteur 0,332 kgCO2e/kWh, rendement du bâtiment 1,2. Nombre d'inférences nécessaires pour que l'inférence égale l'entraînement.
| Modèle | Serveur saturé | 8 requêtes/s | 1 requête/s |
|---|---|---|---|
| Llama 3.1 8B | 276 milliards | 59,5 mds | 9,12 mds |
| Llama 2 13B | 13,3 milliards | 7,52 mds | 1,13 mds |
| OLMo 2 7B | 20,9 milliards | 7,68 mds | 1,05 mds |
| OLMoE 0924 | 21,7 milliards | 3,51 mds | 861 millions |
Conclusion des auteurs : « for most models tested, the number of inferences required to outweigh training costs is in the hundreds of millions to tens of billions ».
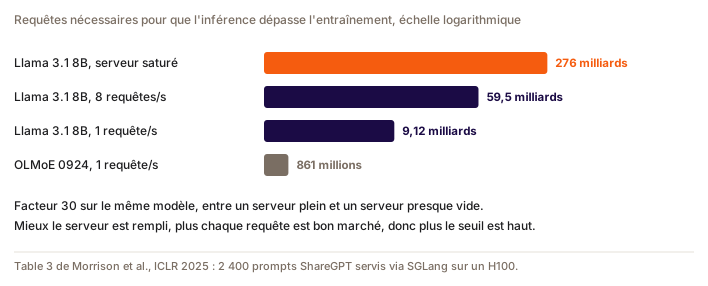
Sur la ligne Llama 3.1 8B, le seuil passe de 9,12 à 276 milliards de requêtes selon le seul remplissage des serveurs. Un facteur 30, alors que le modèle n'a pas bougé.
Question
Un client héberge un modèle open source de 8 milliards de paramètres pour un usage interne de quelques milliers de requêtes par jour. Que lui répondez-vous sur le poids relatif de l'entraînement ?
Choisissez une réponse pour voir l'explication.
Cinq chiffres circulent, aucun ne mesure la même chose
| Source | Chiffre | Grandeur | Objet réel |
|---|---|---|---|
| Patterson et al., Google | 60 % inférence, 40 % entraînement | énergie en kWh | flotte ML complète de Google, R&D incluse, trois échantillons d'une semaine d'avril |
| Wu et al., Meta, figure 3a | 70 % inférence | capacité en mégawatts | infrastructure IA de Facebook |
| Wu et al., Meta, modèle de langage | 65 % inférence | émissions opérationnelles | un modèle, fenêtre calée sur la durée de l'entraînement |
| Wu et al., Meta, modèle de recommandation | 40 % inférence | énergie, phase données incluse | un modèle de recommandation |
| AWS, billet de blog de décembre 2019 | « up to 90 % » | dollars | déclaratif client, majorant, billet de lancement produit |
On compte cinq unités, quatre objets et trois fenêtres temporelles différentes. Ces chiffres ne s'additionnent pas.
Deux corrections. Le fameux 60/40 de Google porte sur trois semaines d'avril en 2019, 2020 et 2021, sur toute la charge d'apprentissage automatique d'un moteur de recherche, avant ChatGPT. Le citer comme la répartition d'un modèle de langage est un contresens de périmètre et de date.
Et le « 80 à 90 % d'inférence » régulièrement attribué à NVIDIA n'a aucune source primaire. Vérification faite sur les pages produit du fabricant : le chiffre n'y figure pas. La chaîne de citation remonte à un article de 2019 sans source au bout. À ne pas reprendre.
Le rapport UNU-INWEH 2026 reprend pourtant le même ordre de grandeur, 80 à 90 % de la consommation totale de l'IA en inférence. Sa note renvoie à Jegham et al., qui citent Desislavov et al., qui citent une conférence AWS de 2020 : au bout de la chaîne, une part de coûts en dollars et un majorant, pas une mesure d'énergie. L'Arcep refuse de trancher, la réponse dépendant du modèle, du nombre de réentraînements et du volume d'utilisateurs.
Ce que ça change pour un bilan carbone
On divise l'empreinte totale d'entraînement par le nombre de tokens servis sur la vie du modèle, puis on ajoute ce quotient à chaque requête. C'est la logique d'analyse de cycle de vie classique.
L'alternative est le coût marginal seul : on ne compte que le calcul supplémentaire causé par la requête, et l'entraînement devient un coût irrécupérable qui n'apparaît nulle part.
Ce que font réellement les acteurs :
| Acteur ou référentiel | Amortit ? | Ce qu'il écrit |
|---|---|---|
| Google, arXiv:2508.15734 | Non | « We leave the measurement of AI model training to future work. » |
| Mistral, ACV de juillet 2025 | Non | parle d'« impacts marginaux de l'inférence », et appelle lui-même l'indicateur manquant de ses vœux |
| SCI for AI, Green Software Foundation | Non, par principe | refuse l'amortissement au motif que le consommateur n'a aucun contrôle sur la façon dont le modèle a été entraîné |
| ITU-T L.1801, février 2026 | Oui | allocation au prorata des inférences sur la vie du modèle |
Les deux textes les plus récents du domaine se contredisent frontalement. Un consultant qui affirme qu'il faut amortir, ou qu'il ne faut pas, se trompe dans les deux cas : la question n'est pas arbitrée, et le travail consiste à dire ce qu'on fait et pourquoi.
Le problème vient du dénominateur. Personne ne publie le nombre de tokens servis sur la vie d'un modèle, si bien que l'amortissement reste impossible à trancher de l'extérieur, quelle que soit la qualité du chiffre d'entraînement.
FAQ
L'entraînement d'un modèle d'IA pollue-t-il plus que son utilisation ?
Cela dépend entièrement du volume servi. Morrison et al. (ICLR 2025) chiffrent le point de bascule entre 861 millions et 276 milliards de requêtes selon le modèle et le remplissage des serveurs. En dessous de ce seuil, l'entraînement amorti domine. Au-delà, l'inférence l'emporte. Le rapport UNU-INWEH 2026 avance 80 à 90 % pour l'inférence à l'échelle du secteur, mais ce chiffre remonte à une estimation de coûts d'AWS, pas à une mesure d'énergie.
Que couvre réellement le chiffre d'entraînement publié par un fournisseur ?
Le seul run final, presque jamais le projet complet. Epoch AI mesure que ce run représente 9,6 % du calcul de recherche chez OpenAI en 2024, 12,3 % chez Z.ai et 22,6 % chez MiniMax. Morrison et al. mesurent de leur côté que le développement représente environ 50 % du run final en tonnes. Le numérateur réel est donc 1,5 à 10 fois plus élevé que le chiffre annoncé.
Pourquoi Meta déclare-t-elle zéro tonne pour l'entraînement de Llama ?
Parce qu'elle publie deux chiffres. Le premier, dit location-based, vaut 11 390 tonnes de CO2e pour Llama 3.1 et correspond à l'électricité réellement appelée sur le réseau. Le second, dit market-based, vaut zéro parce que l'entreprise couvre 100 % de sa consommation par des achats d'énergie renouvelable. Les deux sont exacts dans leur convention comptable respective.
Deux modèles de même taille ont-ils la même empreinte d'entraînement ?
Non, et l'écart vient surtout du lieu. BLOOM et OPT font tous deux environ 175 milliards de paramètres. BLOOM a consommé plus d'énergie, 433 MWh contre 324, et émis 2,8 fois moins, 25 tonnes contre 70, parce qu'il a été entraîné sur un réseau électrique à 57 gCO2eq/kWh contre 231. Le facteur discriminant est le mix électrique, pas l'architecture.
Faut-il amortir l'entraînement sur chaque requête dans un bilan carbone ?
Aucun consensus n'existe. La recommandation ITU-T L.1801 de février 2026 impose l'allocation au prorata des inférences. Le référentiel SCI for AI de la Green Software Foundation la refuse explicitement, au motif que le consommateur ne contrôle pas la façon dont le modèle a été entraîné. Google et Mistral l'excluent tous deux de leurs chiffres publiés. En pratique, le nombre de tokens servis sur la vie d'un modèle n'étant jamais publié, l'amortissement reste impossible à trancher de l'extérieur.