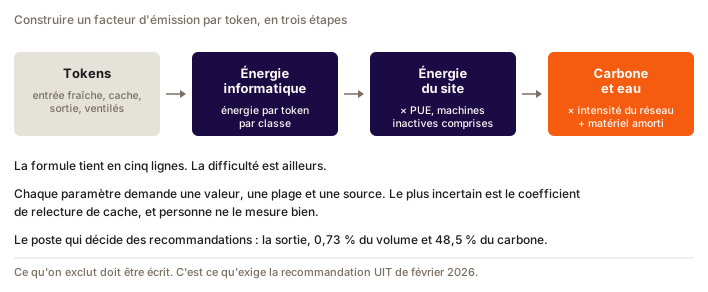
Trois étapes. Le volume de tokens donne une énergie informatique, cette énergie devient l'énergie totale du site, puis on en tire le carbone et l'eau.
La formule fait cinq lignes. Le plus dur est ailleurs : choisir chaque paramètre, déclarer ce qu'on exclut, et accepter un fait contre-intuitif. Sur un usage agentique, la sortie pèse 0,73 % du volume et 48,5 % du carbone.
La formule
Les unités sont écrites à chaque ligne : c'est ce qui permet de repérer qu'une formule trouvée ailleurs n'est pas homogène.
Bloc 1, du volume à l'énergie informatique.
E_IT = T_entrée × e_in  +  T_cache × e_in × f_cache  +  T_sortie × e_out
kWh  = tokens  × kWh/tk +  tokens  × kWh/tk × (sans) +  tokens  × kWh/tk
e_in et e_out sont les énergies unitaires, en kWh par token, mesurées sur le matériel qui sert les requêtes. Ordre de grandeur sur H100 en lot unitaire : 6,05 × 10⁻⁸ kWh par token d'entrée contre 2,13 × 10⁻⁶ kWh par token de sortie, d'où le facteur 35 entre les deux.
f_cache est un rapport sans dimension : la fraction de l'énergie d'un token d'entrée frais que coûte encore un token relu depuis le cache. Valeur retenue 0,08, plage publiée de 0,05 à 0,20.
Bloc 2, de l'énergie informatique à l'énergie totale.
E_totale = E_IT × PUE
kWh      = kWh  × (sans dimension)
Bloc 3, de l'énergie aux impacts.
CO2e     = E_totale × CIF        +  E_IT × EMB
gCO2e    = kWh      × gCO2e/kWh  +  kWh  × gCO2e/kWh

Eau      = E_IT × WUE_site  +  E_totale × WUE_amont
litres   = kWh  × L/kWh     +  kWh      × L/kWh
Deux pièges d'unités, tous deux vus en mission. EMB s'applique à l'énergie informatique, pas à l'énergie totale : le carbone de fabrication est celui des accélérateurs, pas du groupe froid. Et WUE_site s'applique à l'énergie informatique quand WUE_amont s'applique à l'énergie totale, parce que l'eau de production électrique suit tout ce que le site tire du réseau.
Si vous voulez le facteur par token plutôt que le total, divisez la ligne carbone par le nombre de tokens et vous obtenez des gCO2e/token. C'est ce chiffre qui reste comparable dans le temps, là où un chiffre par requête vieillit.
Les grammes de CO2e émis pour produire un kilowattheure sur le réseau électrique où tourne le calcul. En 2025, environ 41 g en France, 384 aux États-Unis, 591 en Pologne, 459 en moyenne mondiale.
Seul ce terme dépend du pays, et le choisir demande trois décisions. Tous les autres sont des propriétés du matériel ou de l'exploitation.
Le carbone de fabrication du matériel, amorti sur sa durée de vie et ramené au kilowattheure informatique. Une carte de huit accélérateurs H100 a une empreinte de fabrication de 1 312 kgCO2e, dont 42 % pour la seule mémoire (PCF NVIDIA HGX H100, juillet 2025, ISO 14067, cradle-to-gate, sans intervalle d'incertitude). Une analyse de cycle de vie indépendante, publiée par l'ADEME en mars 2026, compte 273 kgCO2e par H100 du berceau à la tombe (Lees-Perasso et al., Tableau 44), soit 2 184 kgCO2e pour huit. La méthodologie TokenClimate retient cette valeur depuis sa version 4.7.
Ce terme ne dépend pas du réseau électrique. Plus le mix se décarbone, plus il domine le résultat.
Le composite, et ce qui bouge quand on change de pays
Les blocs 2 et 3 se résument utilement sur la partie carbone :
K_co2 = PUE × CIF + EMB
Exemple sur des valeurs réelles, celles de la méthodologie claude-carbon / TokenClimate. PUE de 1,14, valeur de flotte AWS déclarée pour 2025, donc une moyenne d'opérateur et non le PUE d'un site nommé. CIF de 287 gCO2e/kWh, intensité de la région AWS retenue par Jegham et al. pour Anthropic, dans les versions 5 et 6 du papier (v6 du 24 novembre 2025, la dernière) ; la version 4 donnait 385 g, et personne d'autre ne publie la région d'hébergement. EMB de 49 g par kWh informatique, matériel amorti. Soit 1,14 × 287 + 49 = 376 gCO2e par kWh informatique.
Le CIF est ici le paramètre le plus fragile : il repose sur une région inférée par un tiers, pas déclarée par le fournisseur, et il a bougé de 25 % entre deux versions du même article. Il ne vaut qu'avec sa version et sa date de consultation.
Passez le CIF à la France, 41,4 g chez Ember, et vous obtenez 96,2 g par kWh informatique. Facteur 3,9 sur le composite, et 6,9 sur la seule composante d'usage, selon notre calcul (l'EMB de 49 g est une hypothèse de la méthodologie TokenClimate). Depuis la moyenne américaine, 384 g, ce serait 5,1. Pas 20, comme on l'entend parfois.
Plus le réseau est propre, plus le matériel pèse dans le total. À intensité carbone nulle, le composite ne descend pas sous 49 g. On le retrouve ailleurs : l'analyse de cycle de vie de Lucie 7B (arXiv:2607.05408, juillet 2026) mesure sur la partition H100 du supercalculateur Jean Zay, alimentée par le réseau français, une empreinte annuelle de 417,5 tCO2eq répartie « almost equally between manufacturing and operation ».
Corollaire pour vos réunions : entre deux hyperscalers, débattre du PUE déplace le résultat de quelques pour cent. Changer de pays d'hébergement le déplace d'un facteur 4 à 8 sur le composite (États-Unis ou Pologne contre France). Orientez la discussion.
Ce que la formule écarte, et ce que ça coûte
Le bloc 1 retient deux des trois coefficients publiés par Delavande, Pierrard et Luccioni. Il laisse de côté le troisième, le terme croisé, qui compte la relecture du cache KV à chaque token produit.
La formule complète réunit le bloc 1 et le modèle du papier. T_entrée y désigne les seuls tokens d'entrée frais, comme dans le bloc 1, et T_contexte le contexte entier, frais et relu confondus :
E   = A × T_entrée  +  A × f_cache × T_cache  +  C × T_sortie  +  D × T_contexte × T_sortie
Wh  = Wh/tk × tk    +  Wh/tk × (sans) × tk    +  Wh/tk × tk    +  Wh/tk² × tk × tk

A = 6,05 × 10⁻⁵ Wh/token     C = 2,13 × 10⁻³ Wh/token
D = 2,87 × 10⁻⁷ Wh/token²    f_cache = 0,08
Pourquoi le bloc 1 s'arrête à trois termes. Pas pour une question de validité. A, C et D sortent du même ajustement : un seul modèle en FP32, un seul H100, à lot unitaire. Si le lot unitaire disqualifiait D, il disqualifierait les deux autres. Aucun des trois n'est publié en régime de production groupée, et c'est une limite de toute la formule, pas du quatrième terme.
La raison est pratique. Les trois premiers termes se calculent avec les volumes de tokens par classe. Le quatrième est un produit de deux longueurs, et il faut les connaître requête par requête : la somme des produits n'est pas le produit des sommes. Avec des volumes agrégés seulement, il ne se calcule pas.
Ce que l'omission coûte. Elle n'est pas neutre et elle va toujours dans le même sens, la sous-estimation. À lot unitaire, le terme croisé pèse environ 10 % de l'énergie sur un chat court, 46 % sur un chat long, et 68 % sur une session d'agent à 126 180 tokens de contexte. Sur ce dernier profil, il devient le premier poste et le terme de sortie tombe à 4 %. Ce 4 % ne contredit pas les 48,5 % de la ventilation plus bas : celle-ci omet le terme croisé et applique un rapport sortie sur entrée d'environ 21, sur des sessions réelles et non sur un seul pas.
Ce n'est pas non plus le même objet que le facteur de cache du bloc 1. f_cache est un résidu de préremplissage, compté une fois par requête. Le terme croisé est un coût de décodage, compté une fois par token produit. Les deux décrivent la même relecture vue de deux phases différentes, et les additionner ne serait pas un double comptage.
DONNÉE MANQUANTE. Personne n'a réajusté les trois coefficients à plusieurs tailles de lot. C'est le trou le plus gênant de la méthode, parce qu'il porte sur le terme dominant du seul profil qui monte, l'agentique. Protocole pour le combler : reprendre le protocole de Delavande et al., même modèle et même matériel pour rester comparable, et refaire l'ajustement à des lots de 1, 8, 32 et 128, en balayant la longueur de contexte sur au moins deux ordres de grandeur. Publier les trois coefficients par taille de lot, et le rapport C/A associé.
Tant que ce travail n'est pas fait, la position tenable est celle-ci : la formule vaut pour du chat, elle sous-estime l'agentique, et l'ampleur de la sous-estimation est connue à lot unitaire seulement.
Le paramètre le plus incertain
Sur un usage agentique, la relecture de cache représente l'essentiel du volume. Le facteur f_cache devient donc structurant, et personne ne le mesure bien.
La fraction de l'énergie d'un token d'entrée frais que coûte encore un token relu depuis le cache de prompt. Valeur retenue par la méthodologie TokenClimate : 0,08, plage publiée de 0,05 à 0,20.
Ce facteur modélise ce qui reste du préremplissage, rien à voir avec la génération. Nommer correctement le terme physique évite d'orienter de travers ses révisions futures.
La seule mesure directe disponible, Irminsul (MLA-Native Position-Independent Caching, arXiv:2605.05696), compare l'énergie d'un succès et d'un échec de cache par compteurs NVML, sur un préfixe de 4 096 tokens :
| Architecture d'attention | Échec | Succès | Ratio |
|---|---|---|---|
| GQA, Qwen3-32B | 262,3 J | 37,5 J | 14 % |
| MLA, DeepSeek-V2-Lite | 47,1 J | 17,2 J | 37 % |
| Modèles à espace d'états | n.d. | n.d. | 0 % |
Pourquoi 0,14 n'a pas été adopté malgré une mesure plus récente : le protocole tourne à 4 096 tokens de préfixe quand le pas médian d'un agent de code en contient 126 180. À cette échelle, les coûts fixes de lancement qui dominent les petits cas s'amortissent et le ratio réel baisse, ce que les auteurs reconnaissent eux-mêmes.
Comportement à copier. Un facteur mesuré hors de son domaine de validité ne devient pas bon parce qu'il est récent. On élargit la plage publiée plutôt que de déplacer la valeur centrale. La mesure MLA, à 37 %, reste pourtant hors de la plage actuelle, qui s'arrête à 0,20.
La ventilation qui change les recommandations
Décomposition mesurée sur la base de sessions agentiques de claude-carbon, 17,4 milliards de tokens de janvier à août 2026 :
| Classe de tokens | Part du volume | Part du carbone |
|---|---|---|
| Sortie | 0,73 % | 48,5 % |
| Lecture de cache, facteur 0,08 | environ 90 % | 22,7 % |
| Entrée fraîche et écriture de cache | 8,6 % | 28,8 % |
Trois lectures d'un seul tableau.
Un outil qui compterait toutes les lectures de cache au tarif d'un token d'entrée frais afficherait 3,6 fois plus. S'il comptait tous les tokens au tarif de l'entrée, sortie comprise, il afficherait 3,3 fois plus. C'est l'erreur d'un tableau de bord à compteur unique.
L'entrée fraîche et l'écriture de cache pèsent 28,8 %, donc un compresseur parfait appliqué aux seuls tokens nouveaux, sans effet sur l'historique déjà en cache, ne descendrait pas sous 71 % du total. S'il comprime aussi l'historique relu, le plancher descend vers la part de la sortie, environ 50 %. Avec la borne haute du facteur de cache, ce plancher monte encore.
Les leviers efficaces agissent sur la sortie, moins d'un pour cent du volume et près de la moitié du carbone. Un modèle plus petit. Couper le raisonnement. Et surtout des réponses plus courtes.
Ce profil est propre à l'usage agentique. Sur du chat simple, environ 1 000 tokens d'entrée pour 150 générés, l'entrée pèse 14 % de l'énergie et la compression a beaucoup plus de prise. Un pourcentage de cette ventilation n'a de sens qu'avec le profil sur lequel il a été calculé.
Question
Sur un agent de code, quel levier faites-vous passer en premier dans vos recommandations ?
Choisissez une réponse pour voir l'explication.
Les méthodologies existantes, et ce qu'elles couvrent
| Méthode | Matériel | PUE | Inactif | Réseau | Entraînement |
|---|---|---|---|---|---|
| Google, 2025 | oui | oui | oui | non | non |
| EcoLogits | oui, sur 3 ans | oui | non | non | non |
| LLMCarbon | oui | oui | non explicite | non | oui |
| ML CO2 Impact | non | non | non | non | sans objet |
| SCI, ISO/IEC 21031 | oui | via l'énergie | selon l'unité | selon l'énergie | unité libre |
La formule normalisée par l'ISO tient en une ligne, SCI = (O + M) par R, où O est l'énergie multipliée par l'intensité carbone, M le matériel amorti, et R l'unité fonctionnelle. R est le paramètre libre, donc le premier levier de non-comparabilité : on ne peut pas comparer deux scores conformes calculés avec des R différents.
Deux propriétés distinguent ce cadre d'un reporting classique. Il exclut les compensations : la spécification l'écrit noir sur blanc, un score ne peut baisser que par une réduction réelle. Il mesure par ailleurs un taux, pas un total. Et son terme d'énergie doit couvrir le matériel réservé, pas seulement utilisé, ce qui change tout sur un parc sous-chargé.
Ce qu'il faut publier avec le chiffre
Un facteur n'est défendable que documenté. Le minimum, tel que l'exige la recommandation UIT de février 2026 : description du système, unité fonctionnelle, frontières avec exclusions justifiées, sources et qualité des facteurs, énergie séparée entre entraînement et inférence, et déclaration de conformité totale ou partielle avec les éléments exclus explicités.
La formule « conformité partielle avec exclusions explicites » est ce qu'une méthodologie honnête peut livrer aujourd'hui, sans plus. Et la seule position tenable, puisque aucun référentiel opposable n'impose de méthode.
Pour appliquer tout ceci à un usage réel sans repartir de zéro, la méthodologie TokenClimate publie ses paramètres, leurs plages et leurs sources, et le calculateur fait tourner la formule sur un mix de modèles.
FAQ
Comment calcule-t-on l'empreinte carbone d'un usage de LLM ?
En trois étapes. On convertit d'abord le volume de tokens en énergie informatique, en distinguant l'entrée fraîche, les lectures de cache et la sortie, chacune avec son coefficient. On multiplie ensuite par le PUE du site pour obtenir l'énergie totale. On applique enfin l'intensité carbone du réseau électrique concerné, plus un terme de carbone incorporé du matériel amorti.
Quel poids donner aux tokens lus depuis le cache ?
Environ 0,08 fois l'énergie d'un token d'entrée frais, dans une plage publiée de 0,05 à 0,20. La seule mesure directe disponible donne 14 à 37 % selon l'architecture d'attention, mais elle a été faite sur un préfixe de 4 096 tokens alors qu'une session d'agent en contient environ 126 000, échelle à laquelle le ratio réel baisse.
Quelle part de l'empreinte vient des tokens de sortie ?
Sur un usage agentique mesuré sur 17 milliards de tokens, la sortie représente 0,73 % du volume et 48,5 % du carbone. Les lectures de cache font environ 90 % du volume pour 22,7 % du carbone. Sur du chat simple, la répartition est très différente et l'entrée pèse 14 % de l'énergie.
Changer de pays d'hébergement divise-t-il l'empreinte par 20 ?
Non. Sur notre composite, passer de la région AWS retenue pour Anthropic (287 g) au réseau français donne un facteur 3,9 sur le total et 6,9 sur la seule composante d'usage. Depuis la moyenne américaine (384 g), ce serait 5,1 sur le total. Le PUE et le carbone incorporé du matériel ne bougent pas avec le pays, et le second devient dominant à mesure que le réseau se décarbone.
Existe-t-il une norme pour calculer l'empreinte d'une requête d'IA ?
Aucune norme opposable n'impose de méthode. La spécification SCI, devenue ISO/IEC 21031 en 2024, fournit une formule mais laisse l'unité fonctionnelle libre et ne mentionne jamais l'inférence. La recommandation UIT-T L.1801 de février 2026 est la plus complète, sans être contraignante. La position tenable consiste à déclarer ses frontières et ses exclusions.