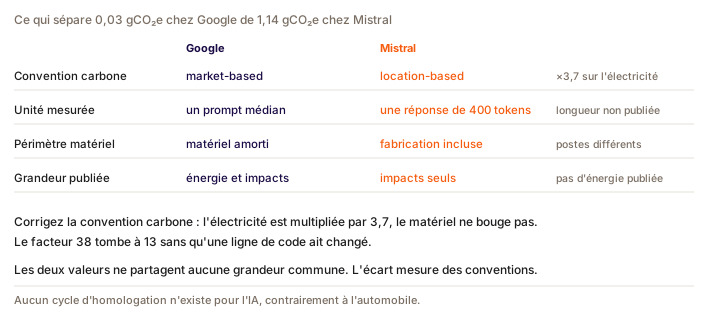
Trois méthodes existent pour chiffrer l'usage IA d'une entreprise : convertir la facture avec un facteur monétaire (spend-based), multiplier un nombre de requêtes par une moyenne publiée, ou compter les tokens réels par modèle. Leurs précisions ne jouent pas dans la même catégorie : un préprint de juin 2026 (Llopis, arXiv 2606.10660) estime qu'un facteur monétaire sectoriel TIC surestime les émissions d'inférence de 10 à 40 fois par rapport à un calcul physique, et la moyenne par requête écrase l'écart entre le prompt médian Gemini (0,03 gCO₂e en market-based, environ 0,09 en location-based recalculé, Google, août 2025) et la réponse de 400 tokens de l'ACV Mistral (1,14 gCO₂e, juillet 2025). Le comptage par token, lui, colle à l'usage réel, ligne par ligne.
Méthode 1 : la facture (spend-based)
Le principe : multiplier les euros dépensés par un facteur d'émission monétaire, en kgCO₂e par euro. C'est la méthode des bilans carbone généralistes, et elle a une qualité, sa disponibilité : la facture existe toujours. Pour l'IA, elle déraille. Le prix du million de tokens varie de plusieurs ordres de grandeur selon le modèle, et les remises comme le cache pèsent sur la facture sans lien avec l'énergie dépensée. Un préprint à auteur unique (Llopis, arXiv 2606.10660, juin 2026) chiffre l'écart : avec un facteur monétaire sectoriel TIC, les émissions d'inférence ressortent 10 à 40 fois plus hautes qu'avec un calcul physique. À réserver au screening initial, pour repérer si le poste IA mérite une mesure plus fine.
Méthode 2 : la requête moyenne
On compte les requêtes, ou les utilisateurs, et on multiplie par un chiffre public. Les références datées existent : environ 0,3 Wh par requête ChatGPT typique (Epoch AI, février 2025), 0,03 gCO₂e en market-based (environ 0,09 en location-based, recalculé) par prompt texte médian Gemini (Google, arXiv 2508.15734, août 2025), 1,14 gCO₂e par réponse de 400 tokens de Mistral Large 2 (ACV Mistral, juillet 2025). Le problème saute aux yeux : selon la référence choisie, le résultat change d'un ordre de grandeur, de 0,03 g à 1,14 g par prompt dans les chiffres cités. Et aucune moyenne ne capture le mix de modèles, alors que les modèles de raisonnement consomment en moyenne 30 fois plus d'énergie que les standards (AI Energy Score v2, Hugging Face, décembre 2025). Utilisable pour sensibiliser en interne, pas pour un chiffre opposable. Le guide sur l'empreinte carbone de ChatGPT détaille ces bornes.
Méthode 3 : le comptage par token
Exporter les volumes de tokens consommés par modèle depuis les consoles d'administration (Anthropic, OpenAI, Google et les autres les exposent), puis appliquer des facteurs par modèle : énergie, CO₂e et eau par million de tokens. On peut vérifier chaque ligne du calcul : volume exporté, facteur sourcé, produit des deux. Les facteurs par modèle sont publics sur les fiches modèles. Équations et hypothèses sont dans la méthodologie, et le calculateur fait le calcul en ligne. Seule cette méthode distingue un usage Haiku d'un usage o3, à volume égal.
Quelle méthode pour quel besoin
Un BEGES réglementaire demande une donnée d'activité défendable : comptage token pour les fournisseurs principaux, spend-based accepté en complément pour le reliquat, à documenter comme tel. Voir où déclarer l'usage IA dans un BEGES. Un appel d'offres public déroule le questionnaire MiNumEco, qui demande la méthodologie : le comptage token est le seul qu'on peut décrire en une phrase vérifiable (guide appel d'offres). Une communication interne de sensibilisation se contente d'une moyenne par requête, datée et sourcée.
Trois pièges à éviter, quelle que soit la méthode
Le premier : confondre tokens d'entrée et de sortie. Les facteurs diffèrent entre les deux, et un usage type RAG, qui injecte de gros contextes, n'a pas le profil d'un usage rédactionnel. Le deuxième piège consiste à compter deux fois le même usage : une équipe qui passe par un outil SaaS branché sur l'API d'un fournisseur apparaît dans la facture du SaaS et dans celle du fournisseur si les deux périmètres sont additionnés sans précaution. Dernier point, le cache : les tokens servis depuis le cache sont facturés à part et ne représentent pas la même consommation qu'une génération. Les annoncer séparément évite une surestimation silencieuse.
FAQ
Peut-on mélanger les méthodes ?
Oui, à condition de l'écrire. Comptage token pour les fournisseurs qui exposent leurs données d'usage, spend-based pour le reliquat, SaaS avec IA embarquée et outils marginaux. Le rapport final indique la part de chaque méthode dans le total.
Où trouver les volumes de tokens ?
Dans les consoles d'administration : Anthropic (API d'usage sur la clé Admin), OpenAI (page usage et exports), Google Cloud (rapports de consommation Vertex). Les exports donnent les tokens d'entrée et de sortie par modèle et par période, la maille qu'il faut pour appliquer des facteurs par modèle.
Et les outils SaaS avec IA embarquée ?
Pas de tokens visibles côté client. Il reste la demande contractuelle d'informations environnementales au fournisseur ; le rapport Arcep de mai 2026, réalisé avec le PEReN, documente le retard de transparence du secteur. En attendant, ce périmètre reste en spend-based, en l'annonçant.
Sources
- Llopis G., préprint sur la comptabilisation de l'inférence IA dans les inventaires GES (juin 2026)
- Epoch AI, énergie d'une requête ChatGPT (février 2025)
- Google, mesure par prompt Gemini (août 2025)
- ACV Mistral AI (juillet 2025)
- AI Energy Score v2, Hugging Face (décembre 2025)
- Arcep, « Intelligence artificielle générative : quels défis environnementaux ? », avec le PEReN (21 mai 2026)
- PEReN, contribution au rapport de l'Arcep (21 mai 2026)