On répond en général « parce que l'attention est quadratique ». C'est vrai. Et incomplet : sur un modèle d'environ 70 milliards de paramètres, le terme quadratique ne devient dominant qu'au-delà de 50 000 tokens environ. Un chat ordinaire en reste loin, mais les sessions d'agent dépassent souvent ce seuil.
Le vrai coût est ailleurs, et il tient au régime de décodage. Le contexte long remplit la mémoire des accélérateurs, ce qui fait s'effondrer le nombre de requêtes traitables ensemble, et c'est cet effondrement qui fait monter l'énergie par token. Les fournisseurs le facturent d'ailleurs explicitement.
Ce que fait l'attention, et ce qu'elle coûte
Prenez « le juge écoute l'avocat » et « j'ai épluché l'avocat ». Le mot entre dans le modèle avec le même vecteur dans les deux cas. L'attention le déplace vers le juriste ou vers le fruit, en y ajoutant une part de l'information de « juge » ou d'« épluché », qui le précèdent.
Chaque token émet une requête, ce qu'il cherche, et une clé, ce qu'il propose. Il transmet aussi une valeur. On calcule le produit de chaque requête avec chaque clé, ce qui donne une matrice de scores de taille n par n, puis on s'en sert pour faire une moyenne pondérée des valeurs.
Cette matrice n par n est l'origine du coût quadratique : doubler la longueur du contexte quadruple le nombre de scores à calculer.
Sauf que l'attention n'est pas le seul poste. Le bloc suivant, qui contient environ 80 % des paramètres de Llama 3 70B, croît linéairement avec la longueur. Tant que le terme linéaire domine, le comportement observé est linéaire.
Le seuil de bascule dépend de conventions rarement explicitées. Avec le masquage causal et les dimensions publiées de Llama 3 :
| Modèle | Attention = 10 % des calculs | 25 % | 50 %, la bascule |
|---|---|---|---|
| Llama 3 8B | 2 958 tokens | 8 875 | 26 622 |
| Llama 3 70B | 5 803 tokens | 17 408 | 52 227 |
| Llama 3.1 405B | 10 809 tokens | 32 427 | 97 281 |
À 8 000 tokens de contexte sur un 70B, l'attention quadratique pèse environ 13 % des calculs. À 32 000, environ 38 %. Le discours « c'est quadratique donc ça explose » est faux dans le régime courant. Il devient vrai plus loin, là où va la course commerciale.
Ces seuils valent pour le token en cours de production, qui consulte tout le contexte. Sur la lecture d'un prompt, chaque token ne consulte que ceux qui le précèdent, soit la moitié du prompt en moyenne : les seuils doublent, et la bascule du 70B passe vers 104 000 tokens.
Le vrai mur : le cache KV
Pour ne pas recalculer les clés et les valeurs de tous les tokens précédents à chaque nouveau token produit, le modèle les conserve en mémoire. Cette réserve grandit linéairement avec la longueur du contexte et doit rester en mémoire haute performance pendant toute la génération.
Elle décide combien de requêtes tiennent simultanément sur un accélérateur, donc combien on peut en traiter dans la même passe, donc l'énergie par token.
| Modèle | Par token | À 128 k tokens (131 072) | À 1 million de tokens |
|---|---|---|---|
| Llama 3 8B | 131,1 kB | 17,2 Go | 131,1 Go |
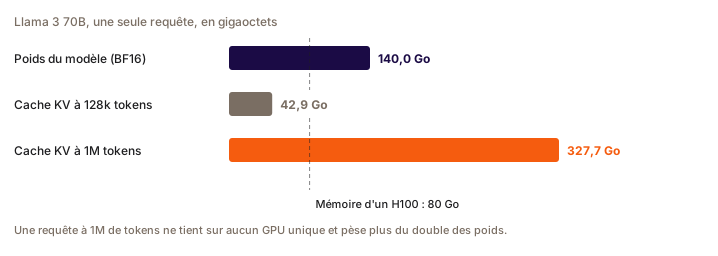
| Llama 3 70B | 327,7 kB | 42,9 Go | 327,7 Go |
| Llama 3.1 405B | 516,1 kB | 67,6 Go | 516,1 Go |
| DeepSeek-V3 (attention compressée) | 70,3 kB | 9,2 Go | 70,3 Go |
Un H100 embarque 80 Go de mémoire, un H200 141 Go, un B200 180 Go. Une seule requête Llama 3 70B à un million de tokens demande environ 330 Go de cache, soit plus du double des 140 Go de poids du modèle, et ne tient sur aucun accélérateur unique.
On mesure l'effet directement. Sur une trace agentique réelle avec environ 67 000 tokens d'entrée médiane, une répartition classique du cache sature la mémoire dès 64 requêtes simultanées et plafonne à 1 863 tokens par seconde et par GPU. Une répartition qui découpe le cache entre les accélérateurs atteint 6 091 tokens par seconde à 512 requêtes simultanées, en n'occupant que 82 % de la mémoire. Facteur 3,3, sans toucher au modèle.
La preuve commerciale
Un fournisseur n'invente pas un palier tarifaire si son coût marginal est linéaire.
| Fournisseur | Modèle | Entrée courte | Entrée longue | Sortie |
|---|---|---|---|---|
| Gemini 3.1 Pro | 2,00 $ | 4,00 $ (>200k) | ×1,5 | |
| Gemini 2.5 Pro | 1,25 $ | 2,50 $ (>200k) | ×1,5 | |
| OpenAI | gpt-6-astra | 10 $ | 20 $ | ×1,5 |
| OpenAI | gpt-5.6-sol | 4 $ | 8 $ | ×1,5 |
Deux fournisseurs indépendants, le même multiplicateur : ×2 sur l'entrée, ×1,5 sur la sortie. Google facture en plus le stockage de son cache explicite jusqu'à 4,50 $ par million de tokens et par heure sur ses modèles haut de gamme.
Le contre-exemple existe et il faut le donner : Anthropic a supprimé son palier, et facture une requête de 900 000 tokens au même tarif unitaire qu'une requête de 9 000. Cela ne prouve pas que le coût est devenu linéaire, seulement que l'entreprise l'absorbe dans son prix moyen. Confondre une décision de tarification avec une propriété physique, c'est l'erreur à repérer.
Question
Sur un modèle de 70 milliards de paramètres servi à 16 000 tokens de contexte, quel poste explique l'essentiel du surcoût par rapport à 4 000 tokens ?
Choisissez une réponse pour voir l'explication.
Le RAG est une technique de sobriété
Si le coût vient de la longueur du contexte, alors n'y mettre que ce qui sert est un levier d'efficacité, pas seulement de pertinence.
Une étude de Google DeepMind mesure le gain sur neuf jeux de données : router chaque question vers une recherche ciblée plutôt que vers le contexte plein réduit le volume de tokens de 61,6 % sur Gemini 1.5 Pro et de 61,2 % sur GPT-3.5-Turbo, pour une performance quasi maintenue.
Deux réserves. Ce sont des tokens, pas des joules : personne n'a publié de comparaison énergétique entre un pipeline de recherche et un contexte plein sur la même tâche. Et le pipeline n'est pas gratuit, puisqu'il faut indexer le corpus, stocker les vecteurs et interroger l'index à chaque appel, coûts qui s'amortissent sur le nombre de requêtes comme un entraînement.
Ce qu'il faut retenir
La fenêtre d'un million de tokens est une prouesse d'ingénierie qu'on paie à l'exploitation, tous les jours, à chaque requête. Étendre une fenêtre coûte peu à l'entraînement. La servir coûte cher.
Pour un audit, le chiffre utile est la longueur d'entrée médiane des appels, pas la taille de contexte que le modèle accepte. Elle se trouve dans les logs.
FAQ
L'attention d'un LLM est-elle vraiment quadratique ?
Oui en théorie, mais elle ne domine le coût qu'au-delà d'un seuil élevé. Sur Llama 3 70B, l'attention quadratique atteint 50 % des calculs vers 52 000 tokens de contexte pour le token produit, et ne pèse qu'environ 13 % à 8 000 tokens. Dans le régime où tournent la plupart des requêtes, le comportement observé est essentiellement linéaire.
Qu'est-ce qui rend réellement le contexte long coûteux ?
Le cache KV, c'est-à-dire les clés et valeurs de tous les tokens précédents conservées en mémoire pendant la génération. Il croît linéairement avec la longueur, occupe la mémoire des accélérateurs, et réduit d'autant le nombre de requêtes traitables simultanément. Or l'énergie par token dépend directement de ce regroupement.
Quelle place occupe le cache KV d'une requête à un million de tokens ?
Environ 330 Go pour Llama 3 70B en précision 16 bits, soit plus du double des 140 Go que pèsent les poids du modèle, et bien au-delà des 80 Go d'un H100 ou des 180 Go d'un B200. Une architecture à attention compressée comme celle de DeepSeek-V3 ramène ce chiffre à environ 70 Go.
Pourquoi certains fournisseurs facturent-ils le contexte long plus cher ?
Parce que leur coût marginal n'est pas linéaire. Google et OpenAI appliquent tous deux un multiplicateur de 2 sur les tokens d'entrée au-delà de leur palier de contexte et de 1,5 sur la sortie. Anthropic a fait le choix inverse et facture la fenêtre entière au tarif standard, ce qui relève d'une politique commerciale et non d'une différence physique.
Le RAG réduit-il l'empreinte carbone par rapport à un contexte long ?
Il réduit le volume de tokens envoyés au modèle, mesuré à environ 61 % dans une étude de Google DeepMind à performance quasi maintenue. Aucune étude publiée ne compare l'énergie des deux approches sur la même tâche, et le calcul doit intégrer l'indexation du corpus et les requêtes de recherche, qui s'amortissent sur le volume d'usage.