Votre phrase est d'abord découpée en morceaux. Chaque morceau est converti en nombres, que le modèle ajuste selon les mots qui l'entourent, puis qu'il fait passer dans des dizaines de couches de calcul. Le modèle fait ce trajet en deux temps : il lit d'abord votre message d'un bloc, puis il écrit sa réponse mot après mot.
Il y a six étapes, et chacune correspond à un poste de consommation. Elles expliquent pourquoi le français coûte plus cher que l'anglais, pourquoi écrire coûte plus que lire, ce que coûte une longue conversation, et comment un modèle géant peut consommer moins qu'un petit.
Étape 1 : votre texte est découpé en tokens
Un modèle ne travaille ni sur des lettres ni sur des mots entiers. Il travaille sur des morceaux de mots, tirés d'un dictionnaire fixe construit avant son entraînement.
Les morceaux fréquents y ont leur propre entrée. « Bonjour » tient en un seul morceau. Un mot rare comme « anticonstitutionnellement » est coupé en quatre ou cinq.
Le morceau de texte que le modèle manipule. Sur les tokenizers actuels d'OpenAI, un token vaut environ 4,9 caractères en anglais et 4,3 en français.
Ce que vous payez, ce que la machine calcule et l'électricité qu'elle consomme se comptent tous en tokens.
Le français cumule deux handicaps. Il met moins de caractères dans chaque token, et il lui faut environ 20 % de caractères de plus que l'anglais pour dire la même chose. Résultat, le même texte demande environ 37 % de tokens de plus en français, sur les tokenizers actuels d'OpenAI. En birman, c'est plus de trois fois plus, et jusqu'à près de quatorze fois plus pour les langues les moins représentées. Vous payez la différence, en euros comme en carbone.
Le détail et la mesure : le français coûte-t-il plus cher que l'anglais.
Étape 2 : chaque token devient une liste de nombres
On ne peut rien calculer avec un numéro de dictionnaire. Le token 4 827 n'est pas « plus grand » que le token 312. Le modèle remplace donc chaque numéro par une longue liste de nombres, 8 192 sur Llama 3 70B, un modèle de Meta à 70 milliards de paramètres, qui place le token dans un espace où les mots de sens proche sont voisins.
Cette liste de départ est la même pour toutes les phrases. « Avocat » entre avec les mêmes nombres dans « le juge écoute l'avocat » et dans « j'ai épluché l'avocat ». Le modèle ne sait pas encore de quel avocat il s'agit.
Il ne sait pas non plus dans quel ordre arrivent les mots. On lui ajoute donc la position de chaque token, aujourd'hui le plus souvent avec une méthode appelée RoPE. Elle permet d'allonger la fenêtre de contexte d'un modèle existant sans le réentraîner de zéro : Llama 3 est passé de 8 000 à 128 000 tokens avec environ 5 % de ses données d'entraînement. Allonger la fenêtre coûte donc peu à l'entraînement. S'en servir coûte cher, et l'étape 6 explique pourquoi.
Étape 3 : l'attention ajuste chaque mot selon son contexte
L'attention est le mécanisme central de ces modèles. Elle déplace les nombres d'« avocat » vers le juriste ou vers le fruit, selon les mots qui le précèdent.
Chaque token produit trois listes de nombres : une requête (ce qu'il cherche), une clé (ce qu'il propose aux autres) et une valeur (ce qu'il transmet). Le modèle compare la requête de chaque token aux clés des tokens précédents, et chaque token récupère un mélange des valeurs, pondéré par ces comparaisons.
Deux conséquences comptent pour la consommation.
La première : le nombre de comparaisons grimpe au carré de la longueur du texte. Cent tokens font environ cinq mille comparaisons, deux cents en font vingt mille. C'est le coût dit quadratique de l'attention. Il ne devient pourtant le premier poste de calcul qu'au-delà d'environ 50 000 tokens de contexte sur Llama 3 70B, parce que le reste du modèle pèse beaucoup plus. Un chat ordinaire reste loin de ce seuil, mais les sessions d'agent le dépassent souvent.
La seconde : un token ne regarde que ceux qui le précèdent, puisque le modèle apprend à prédire la suite. Sa représentation ne change donc plus une fois calculée, et le modèle peut la garder en mémoire au lieu de la recalculer. On y revient à l'étape 6.
Le détail : pourquoi le contexte long coûte si cher.
Étape 4 : le gros du calcul, dans les couches denses
L'attention fait circuler l'information entre les mots, mais elle ne contient qu'une petite partie des paramètres. Sur Llama 3 70B, environ 80 % d'entre eux se trouvent dans les couches qui suivent chaque bloc d'attention, et qui transforment chaque token séparément.
On peut maintenant chiffrer le travail. Produire un token demande environ deux opérations par paramètre traversé. Un modèle de 70 milliards de paramètres fait donc à peu près 140 milliards d'opérations pour chaque token.
Un FLOP est une opération de calcul : une quantité de travail, comme une distance. Un FLOPS est un nombre d'opérations par seconde : la puissance d'une machine, comme une vitesse. On voit souvent l'un écrit pour l'autre.
Cette unité a une portée réglementaire. Le règlement européen sur l'IA demande aux fournisseurs de modèles d'usage général la consommation d'énergie de leur modèle, et admet, quand elle est inconnue, une estimation à partir des ressources de calcul utilisées.
Une architecture a changé le lien entre la taille d'un modèle et sa consommation.
Au lieu d'une grosse couche dense, le modèle en contient des dizaines, voire des centaines, plus petites et spécialisées : les experts. Pour chaque token, un aiguilleur en choisit quelques-uns, et les autres ne calculent pas.
Kimi K2, par exemple, compte 1 000 milliards de paramètres et n'en active que 32 milliards par token. Le calcul baisse d'autant, mais tous les experts doivent rester chargés en mémoire, puisqu'on ne sait pas à l'avance lesquels serviront.
Pour comparer deux modèles, le nombre de paramètres annoncé ne suffit donc plus. Le chiffre utile est le nombre de paramètres actifs par token, parfois trente fois plus petit que celui du communiqué de presse.
Le détail : ce que change le Mixture of Experts.
Le bloc transformer
Une couche d'attention suivie d'une couche dense forment un bloc, qu'on appelle transformer depuis l'article de 2017 qui l'a proposé. Llama 3 70B en empile quatre-vingts. Tous les modèles de ce cours sont des variantes de ce motif : ils diffèrent par le nombre de blocs, la longueur des listes de nombres et le découpage ou non des couches denses en experts.
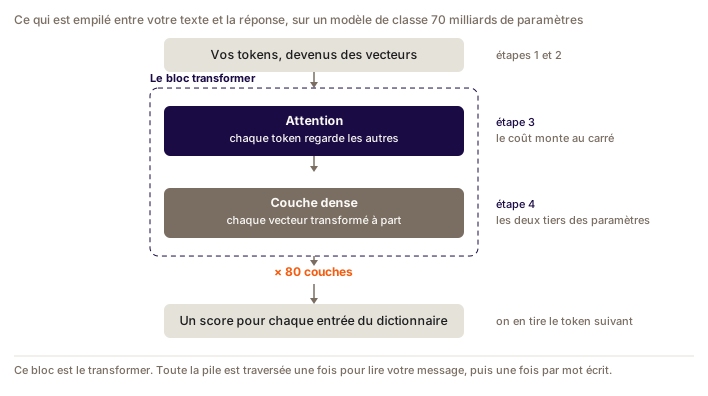
À la sortie du dernier bloc, le modèle donne un score à chaque entrée de son dictionnaire. Ces scores deviennent des probabilités, et le token suivant est tiré au sort selon elles. La température règle ce tirage. Basse, elle fait presque toujours sortir le token le plus probable, et les réponses varient peu. Haute, elle laisse sortir des tokens moins probables, et les réponses varient davantage.
Étape 5 : lire et écrire, deux régimes opposés
Les quatre-vingts blocs sont parcourus de deux façons, selon que le modèle lit ou qu'il écrit.
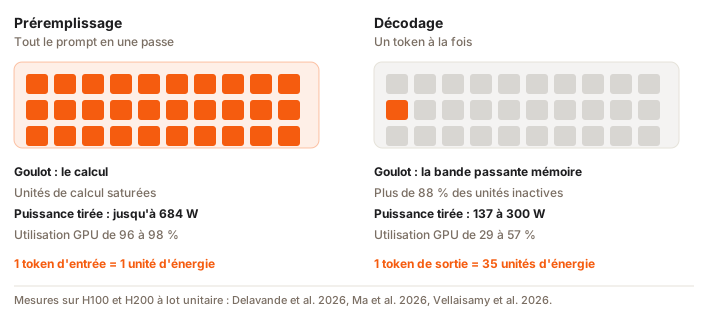
Le modèle lit tout votre message d'un bloc. Tous les tokens traversent les couches en même temps, et les unités de calcul tournent à plein. C'est la phase la moins chère par token.
Le modèle écrit sa réponse token après token, puisque chaque mot dépend de celui d'avant. Pour chaque token, il doit relire tous ses paramètres depuis la mémoire. Les unités de calcul passent l'essentiel de leur temps à attendre : les cœurs tenseurs, qui font le calcul matriciel, restent inactifs à plus de 88 % dans les mesures de Ma et al. sur un H200.
D'où un écart qu'on retrouve dans tout le cours. Quand la machine ne traite qu'une requête à la fois, un token écrit consomme environ 35 fois un token lu, dans la mesure de référence faite sur un modèle de 8 milliards de paramètres. Le prix facturé affiche le plus souvent un rapport de 5. Sur une conversation courte, c'est donc la longueur des réponses qui pèse. Sur une session d'agent, le contexte relu à chaque token écrit prend le dessus, et c'est sa longueur qu'il faut surveiller.
Le détail et les mesures : pourquoi un token de sortie coûte plus qu'un token d'entrée.
Étape 6 : ce que le modèle garde en mémoire
Pour écrire son cinquantième mot, le modèle a besoin de tout ce qui précède. Il garde donc en mémoire ce qu'il a calculé à l'étape 3 pour chaque token, au lieu de tout recalculer à chaque mot.
Les clés et les valeurs de tous les tokens déjà vus, gardées dans la mémoire rapide de la puce pendant toute la réponse. Cette réserve grandit avec la longueur de la conversation. Sur Llama 3 70B, un million de tokens occuperaient plus de 300 Go, plus du double des 140 Go du modèle lui-même.
Ce partage pèse lourd. Une puce qui traite trente-deux conversations à la fois relit les paramètres du modèle une fois pour trente-deux réponses. Sur des modèles d'environ 4 milliards de paramètres et 4 000 tokens de contexte, Ma et al. mesurent un écart d'énergie par token d'un facteur 17 à 25 entre une conversation seule et un lot complet. Le gain fond quand le contexte s'allonge, puisque chaque conversation prend plus de place.
Ce levier appartient au fournisseur, presque jamais au client. C'est pour ça qu'héberger soi-même un modèle utilisé à faible volume consomme plus qu'appeler une API partagée par beaucoup d'utilisateurs.
Question
Vous écrivez un prompt de 2 000 mots et le modèle répond en 100 mots, sur une machine qui ne traite que votre requête. Où est passé l'essentiel de l'énergie ?
Choisissez une réponse pour voir l'explication.
Ce qu'il faut retenir avant la suite
Le découpage en tokens fixe l'unité de compte, et il pénalise les langues peu représentées. Chaque token devient une liste de nombres, que l'attention ajuste selon le contexte. La plupart des paramètres se trouvent dans les couches denses, et les modèles à experts n'en activent qu'une partie.
Le modèle lit tout le prompt d'un coup et écrit un token à la fois, ce qui rend l'écriture bien plus chère que la lecture. La place que prend chaque conversation en mémoire décide du nombre de conversations qu'une puce peut mener de front, donc de l'énergie de chacune.
Le reste du cours chiffre ces six étapes avec des sources, puis en tire un facteur d'émission par token.
La suite logique : pourquoi compter en tokens plutôt qu'en requêtes.
FAQ
Comment fonctionne un LLM, étape par étape ?
Votre texte est d'abord découpé en tokens, des morceaux de mots tirés d'un dictionnaire fixe. Chaque token est remplacé par une liste de plusieurs milliers de nombres qui le situe dans un espace de sens, et on y ajoute sa position. Le mécanisme d'attention ajuste ensuite ces nombres selon les mots qui l'entourent. Les couches denses, qui contiennent la plupart des paramètres, transforment chaque token. Le modèle parcourt ces couches une première fois pour lire tout le prompt, puis une fois par token pour écrire la réponse.
Qu'est-ce que le mécanisme d'attention dans un modèle de langage ?
Le mécanisme qui permet à chaque mot d'ajuster son sens en fonction des autres. Chaque token compare ce qu'il cherche à ce que proposent les tokens précédents, et récupère un mélange de leurs informations, pondéré par ces comparaisons. « Avocat » entre avec les mêmes nombres dans « l'avocat a plaidé » et « l'avocat était mûr » ; l'attention le fait basculer vers le juriste ou vers le fruit.
Pourquoi dit-on que l'attention est quadratique ?
Parce que chaque token se compare à tous ceux qui le précèdent. Cent tokens font environ cinq mille comparaisons, deux cents en font vingt mille : doubler la longueur du texte quadruple le nombre de comparaisons. Sur Llama 3 70B, ce poste ne devient pourtant le premier qu'au-delà d'environ 50 000 tokens de contexte, parce que les couches denses, qui ne croissent qu'en proportion de la longueur, pèsent beaucoup plus avant ce seuil.
Qu'est-ce qu'un embedding et pourquoi le modèle en a-t-il besoin ?
On ne peut rien calculer avec un numéro de dictionnaire. L'embedding remplace ce numéro par une liste de plusieurs milliers de nombres, apprise pendant l'entraînement, qui place les mots de sens proche à des positions proches. Cette liste de départ est la même dans toutes les phrases : c'est l'attention qui l'ajuste ensuite au contexte.
Pourquoi écrire coûte-t-il plus cher que lire pour une IA ?
Parce que les deux phases ne tournent pas de la même façon. La lecture traite tous les tokens du prompt en même temps et fait tourner les unités de calcul à plein. L'écriture produit un token à la fois, et le modèle doit relire tous ses paramètres depuis la mémoire pour chacun : la puce passe l'essentiel de son temps à attendre. Quand la machine ne traite qu'une requête, un token écrit consomme environ 35 fois un token lu, alors que le prix facturé affiche le plus souvent un rapport de 5.