Parce que c'est en tokens que le modèle calcule, que le fournisseur facture et que l'électricité se dépense. Une « requête » peut contenir dix mots ou un rapport de cent pages. Comme unité de mesure, elle ne dit presque rien.
Ce qu'est un token
Un morceau de texte, souvent un bout de mot. Le modèle découpe tout ce que vous lui envoyez en tokens avant de le lire, et il écrit sa réponse token par token.
En français, un token fait en moyenne 4,3 caractères, contre 4,9 en anglais (mesure sur le tokenizer o200k d'OpenAI). Les tokenizers récents de Claude découpent plus fin et en produisent davantage pour le même texte.
Le découpage est appris une fois pour toutes, sur un très gros corpus de textes. Les suites de lettres fréquentes y deviennent un seul token, les rares sont coupées en plusieurs morceaux. L'algorithme le plus répandu s'appelle BPE.
Une langue bien représentée dans ce corpus coûte donc moins de tokens qu'une langue rare. Personne n'a fixé de tarif par langue. Le corpus choisi par les concepteurs du modèle aboutit pourtant au même résultat.
Pourquoi la requête mesure mal
D'abord, une requête n'a pas de taille fixe. Un échange de chat simple tourne autour de 1 150 tokens, 1 000 lus et 150 écrits. Un seul pas d'une session Claude Code renvoie au modèle 126 180 tokens de contexte en valeur médiane, d'après les 2 676 sessions analysées par TraceLab. Les deux comptent pour « une requête », avec un facteur 110 entre elles.
Ensuite, la taille moyenne d'une requête bouge, et vite. Les modèles de raisonnement écrivent des brouillons avant de répondre, les agents renvoient tout l'historique à chaque tour, et les contextes s'allongent. Dans le même temps, l'énergie par token baisse : Google annonce une division par 33 de l'énergie de sa requête médiane Gemini en un an (Google, 2025).
Un facteur par requête mélange ces deux mouvements. Quand il change, on ne sait pas si les requêtes ont grossi ou si les machines sont devenues plus efficaces, et on ne sait même pas dans quel sens il se trompe. Compter en tokens sépare les deux.
Tous les tokens ne coûtent pas la même énergie
Un facteur par token se compare d'un outil à l'autre, à une condition : dire de quel token on parle. Il y en a quatre sortes.
| Sorte de token | Ce que c'est | Énergie, rapportée à l'entrée |
|---|---|---|
| Entrée fraîche | texte que le modèle lit pour la première fois | 1, la référence |
| Écriture de cache | texte lu puis mis de côté pour les tours suivants | 1 (facturée un peu plus cher) |
| Lecture de cache | texte déjà lu, repris dans le cache | environ 0,08, une valeur retenue entre 0,05 et 0,20 |
| Sortie | chaque token écrit par le modèle, brouillon de raisonnement compris | environ 35 |
Le rapport de 35 est mesuré quand la machine ne traite qu'une requête à la fois. En production, elle en traite des dizaines ensemble et l'écart se resserre, mais personne ne publie de valeur pour ce régime. La méthodologie TokenClimate retient pour Claude un rapport d'environ 21, tiré des estimations de Jegham et al.. Le prix, lui, suit d'autres rapports : la sortie est facturée 5 fois l'entrée, la lecture de cache 0,025 à 0,1 fois selon le modèle chez Anthropic (grille au 10 octobre 2026).
Ces écarts changent complètement la lecture d'un volume. Sur 17,4 milliards de tokens de sessions d'agent de code mesurées par claude-carbon entre janvier et août 2026, calculés avec cette méthodologie, la sortie fait 0,73 % du volume et 48,5 % du carbone. La lecture de cache fait environ 90 % du volume et 22,7 % du carbone.
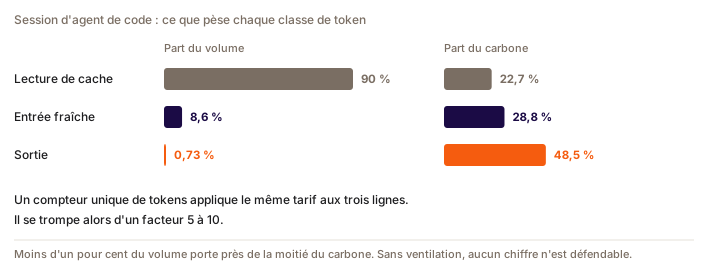
Un tableau de bord qui additionne tous les tokens au même tarif se trompe donc lourdement. Sur ce profil, s'il compte tout au tarif de l'entrée, il affiche 3,3 fois trop. S'il ne se trompe que sur le cache, il affiche 3,6 fois trop.
Cette formule a une limite connue. Elle ne compte pas la relecture de tout le contexte à chaque token écrit, un coût qui grossit avec la longueur de la conversation. Sur un agent, il pèse lourd, et le vrai chiffre est plus haut : le chapitre 12 le chiffre.
Question
Une équipe consomme 1 milliard de tokens par mois. Quelle information vous manque le plus pour en tirer une empreinte ?
Choisissez une réponse pour voir l'explication.
Le compte de tokens dépend du tokenizer
Un même texte ne donne pas toujours le même nombre de tokens. Anthropic l'écrit sur sa page de tarification :
Claude 4.7 and later models and Claude Mythos Preview use a newer tokenizer that contributes to their improved performance on a wide range of tasks. This tokenizer produces approximately 30% more tokens for the same text. The exact increase depends on the content and workload shape. Claude Sonnet 4.6 and earlier models use the previous tokenizer.
À texte égal, le compte augmente donc d'environ 30 % selon le contenu, et la facture avec lui si le prix par token ne bouge pas. Si vous partez des tokens réellement facturés, il n'y a rien à corriger : le compte reflète déjà le découpage du modèle utilisé. L'écart compte surtout pour lire une évolution. Après un changement de modèle, le même travail peut afficher plus de tokens sans que l'usage ait bougé.
Ce que ça change en pratique
Pour un bilan, demandez l'export d'usage en tokens, réparti par modèle, par sorte de token et par période. Anthropic le fournit aux comptes d'organisation par son API Usage.
Un chiffre tiré de la seule facture, multiplié par un facteur monétaire, reste fragile. Ces facteurs ont été construits sur des services numériques dont la structure de coût n'a rien à voir avec celle d'une API de modèle, où le prix intègre la marge et le positionnement commercial. DONNÉE MANQUANTE sur l'ampleur de l'écart : aucune publication ne compare un facteur monétaire à une mesure en tokens sur le même usage. Ce travail ne peut se faire que chez un client qui dispose des deux.
Le chapitre suivant : à contenu identique, le nombre de tokens dépend de la langue.
FAQ
Faut-il compter les requêtes ou les tokens pour mesurer l'usage de l'IA ?
Les tokens. Le calcul du modèle, la facture du fournisseur et l'électricité consommée dépendent du nombre de tokens traités. Une requête de chat simple fait environ 1 150 tokens, un pas d'agent de code plus de 100 000 : un facteur par requête ne permet pas de comparer les deux.
Pourquoi un facteur d'émission par requête vieillit-il mal ?
Parce que la taille moyenne d'une requête augmente, sous l'effet des modèles de raisonnement, des agents et des contextes plus longs, pendant que l'énergie par token baisse. Un facteur par requête mélange ces deux mouvements : son erreur change de taille et même de sens sans que rien ne le signale.
Tous les tokens consomment-ils la même énergie ?
Non. Un token de sortie consomme environ 35 fois un token d'entrée quand la machine traite une requête à la fois, et la méthodologie TokenClimate retient environ 21 pour Claude. Un token relu dans le cache est compté à environ 0,08 fois un token d'entrée. Sur une session d'agent de code, la sortie fait moins de 1 % du volume et près de la moitié du carbone, et un compteur unique se trompe d'un facteur 3,3 à 3,6.
Combien de caractères représente un token ?
Sur le tokenizer o200k d'OpenAI, environ 4,9 caractères en anglais et 4,3 en français, soit à peu près 1,23 token par mot en anglais et 1,44 en français. Le tokenizer de Claude Opus 4.7 et des modèles suivants en produit environ 30 % de plus. Ces valeurs ne valent ni pour du code ni pour les langues à écriture non latine.
Le nombre de tokens d'un texte est-il stable dans le temps ?
Non. Anthropic indique que le tokenizer introduit avec Claude Opus 4.7 produit environ 30 % de tokens en plus pour le même texte, selon le contenu (de 0 à 35 % selon l'annonce d'avril 2026). Si vous partez des tokens facturés, le compte reflète déjà le découpage du modèle utilisé. L'écart compte surtout pour comparer deux périodes séparées par un changement de modèle.