L'Agence internationale de l'énergie (Key Questions on Energy and AI, avril 2026) estime l'électricité GPU d'une requête à 0,05 Wh pour un modèle moyen sans raisonnement, et à 50 Wh pour un agent qui raisonne en quatre à six appels successifs : un rapport de 1 000, selon notre calcul sur sa figure 2.1, que l'AIE donne comme un ordre de grandeur. Le mécanisme n'a rien de mystérieux : à chaque tour, le client renvoie l'intégralité de l'historique au modèle.
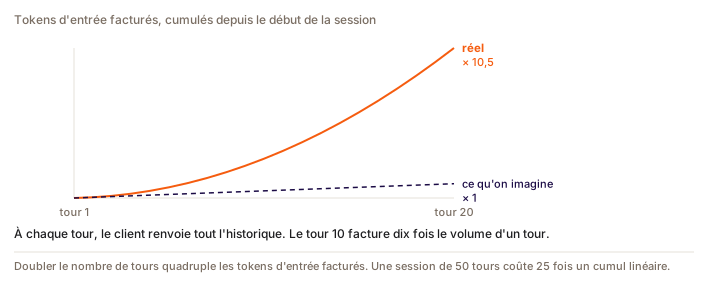
Conséquence arithmétique : doubler le nombre de tours quadruple les tokens d'entrée facturés. Aucun gain d'efficacité matérielle n'absorbe un facteur 4 par doublement.
Une boucle, pas un échange
Le modèle produit une action, reçoit le résultat de l'environnement, relit tout, puis recommence, jusqu'à ce que la tâche soit finie. Les actions sont des appels d'outils : lire un fichier, exécuter du code, interroger une API, faire une recherche.
Pour un bilan carbone, la conséquence est que l'unité pertinente cesse d'être la requête. Une tâche agentique est une session de plusieurs dizaines de tours, dont chacun est facturé et consommé séparément.
Deux propriétés mécaniques comptent pour la suite.
L'API est sans état. Le modèle ne se souvient de rien. À chaque tour, le client lui repasse la conversation entière, et le fournisseur la traite entièrement.
Le contexte contient bien plus que la conversation. Il y a le prompt système, les définitions d'outils, les fichiers d'instructions et les résultats des appels précédents. Sur un agent de code, le seul prompt système pèse plusieurs dizaines de milliers de tokens, renvoyés à chaque tour. DONNÉE MANQUANTE sur la valeur exacte : aucun éditeur ne publie la taille de son prompt système, et elle change à chaque version du produit. Elle se mesure côté client, en comptant les tokens d'entrée du premier tour d'une session vide.
La croissance quadratique du dialogue
Si chaque tour ajoute A tokens, question et réponse comprises, le tour numéro i facture i fois A tokens d'entrée. Le cumul après N tours vaut donc A × N × (N+1) / 2, une croissance en carré du nombre de tours.
Avec 1 000 tokens ajoutés par tour :
| Tours | Entrée cumulée facturée | Si c'était linéaire | Surcoût |
|---|---|---|---|
| 5 | 15 000 tokens | 5 000 | ×3,0 |
| 10 | 55 000 | 10 000 | ×5,5 |
| 20 | 210 000 | 20 000 | ×10,5 |
| 50 | 1 275 000 | 50 000 | ×25,5 |
| 100 | 5 050 000 | 100 000 | ×50,5 |
Au tarif d'entrée de Claude Sonnet 5.5, deux dollars par million de tokens, une conversation de 50 tours coûte 2,55 dollars en tokens d'entrée seuls, contre 0,10 dollar si l'historique n'était pas renvoyé.
Précision de rigueur : cette formule est une dérivation arithmétique élémentaire, pas une citation. Aucune source publiée ne documente ni ne chiffre explicitement ce phénomène. L'article d'ingénierie d'Anthropic sur le context engineering, publié le 29 septembre 2025, traite le sujet sans aucun chiffre : il parle de « context rot » et de contexte comme ressource finie à rendements décroissants, et recommande des résumés condensés « souvent de 1 000 à 2 000 tokens ».
Ce que le cache corrige, et ce qu'il ne corrige pas
Ce terme quadratique est le même que celui décrit au chapitre sur le contexte long. Le préfixe est justement la partie qui se répète, donc la mise en cache réduit exactement ce terme quadratique.
Quand le début d'un contexte a déjà été traité, le fournisseur peut réutiliser le travail au lieu de le refaire. OpenAI et Google facturent cette relecture environ 10 % du prix d'un token d'entrée frais (OpenAI descend à 5 % sur gpt-6.1-sol, Google facture en plus le stockage du cache à l'heure). Chez Anthropic : 5 % sur Opus 5.5 et Sonnet 5.5, 2,5 % sur Fable 5.1 et Mythos 5.1, 10 % sur les autres modèles, dont Haiku 5.5. Grilles au 10 octobre 2026.
Côté énergie, la méthodologie TokenClimate compte un token relu à 0,08 fois l'énergie d'un token d'entrée frais, dans une plage publiée de 0,05 à 0,20. C'est le paramètre le moins bien mesuré du domaine, et il pèse lourd puisqu'il s'applique à l'essentiel du volume d'une session.
Sur l'exemple à 50 tours, avec la lecture de cache de Sonnet 5.5 à 5 % du prix d'entrée, les 2,55 dollars tombent à environ 0,25 dollar : les 1 000 tokens nouveaux de chaque tour restent au plein tarif, majoré de 25 % pour l'écriture en cache. Mesuré sur des sessions réelles plutôt qu'en théorie, le gain est un peu plus faible : Lumer et al. (Don't Break the Cache, arXiv:2601.06007, 9 janvier 2026), sur plus de 500 sessions d'agent du banc DeepResearch Bench, relèvent −79,6 % de coût sur GPT-5.2, −78,5 % sur Claude Sonnet 4.5 et −41,4 % sur Gemini 2.5 Pro. L'écart avec la remise du tarif de lecture, −90 % à 10 %, n'est pas un désaccord, c'est un changement de dénominateur : la remise porte sur les tokens relus, les −78,5 % sur la session entière.
Ce que le cache ne change pas, Anthropic l'écrit sans détour : « Cached prompt prefixes still occupy the context window: prompt caching changes what you pay for those tokens, not whether they count. » La fenêtre se remplit à la même vitesse, et les limites de débit s'appliquent sur le volume total.
Second effet, propre aux modèles récents : les blocs de raisonnement des tours précédents sont conservés par défaut et comptent dans la fenêtre comme des tokens d'entrée. Un token de raisonnement est donc facturé une fois au tarif de sortie quand il est produit, puis au tarif d'entrée à chaque tour suivant.
Et une question de fond reste ouverte. Aucun fournisseur n'indique s'il conserve l'état de calcul en mémoire ou s'il le recalcule. Une seule mesure compare l'énergie d'une lecture de cache réussie à celle d'un échec, Irminsul, et sur un préfixe de 4 096 tokens seulement. Le fait que Google facture un stockage horaire pour son cache explicite, jusqu'à 4,50 dollars par million de tokens et par heure, indique qu'une ressource physique est bien immobilisée. Écrire que le cache divise l'empreinte par dix serait une extrapolation du prix vers l'énergie.
Ce que consomme réellement une tâche agentique
Chiffres publics du classement Terminal-Bench 4.0, relevés le 3 septembre 2026 et revérifiés le 10 octobre 2026. Ce sont des totaux agrégés sur l'ensemble du banc d'essai, tous essais confondus.
| Modèle | Agent | Taux de résolution | Tokens | Coût |
|---|---|---|---|---|
| GPT-6 Astra | Codex | 58,2 % | 1,5 Md | 3 300 $ |
| Fable 5.1 | Claude Code | 57,9 % | 2,7 Md | 6 200 $ |
| Opus 5 (xhigh) | Claude Code | 53,9 % | 6,9 Md | 6 100 $ |
| GLM-5.3 | Claude Code | 41,8 % | 8,7 Md | 2 700 $ |
| GPT-5.6 Sol | Codex | 37,3 % | 4,4 Md | 2 500 $ |
| Gemini 3.8 Flash | mini-SWE-agent | 19,1 % | 17,2 Md | 1 800 $ |
Le classement publie 66 tâches et 330 essais par modèle, soit cinq essais par tâche, ce qui rend le coût par tâche calculable : environ 50 dollars la tâche pour GPT-6 Astra, 10 dollars l'essai. Le haut du classement a bougé depuis le premier relevé (Opus 5.5, Sonnet 5.5 et GPT-6.1 Sol sont passés devant) ; le tableau garde les six modèles d'origine. Côté SWE-bench, les classements officiels publient un coût pour une partie des soumissions seulement, et aucun nombre de tokens, donc la comparaison s'arrête là.
Passer une seule fois ce banc d'essai coûte 1,5 à 17 milliards de tokens et 1 800 à 6 200 dollars, sur les six modèles du tableau.
Regardez maintenant les deux dernières colonnes. Gemini 3.8 Flash consomme 11,5 fois plus de tokens que GPT-6 Astra, et c'est pourtant le passage le moins cher du tableau. Entre le plus cher et le moins cher, l'écart de coût n'est que de 3,4. Le prix par token varie tant entre modèles qu'il inverse le classement de consommation. Le coût seul ne suffit pas à piloter l'énergie.
Question
Sur une session d'agent de code de plusieurs heures, quel poste représente l'essentiel du volume de tokens ?
Choisissez une réponse pour voir l'explication.
Ce que décide le harness
Opinion d'Ismael Velasco, au panel « Conceptual definitions and indirect impacts » de la journée ENS/OBVIA du 9 juin 2026 : « If you have a really efficient model in a really inefficient harness, the impacts will be way worse than a really inefficient model in a really efficient harness. » DONNÉE MANQUANTE sur la référence : aucun enregistrement public de l'intervention n'a pu être retrouvé.
Le logiciel qui entoure le modèle : gestion du contexte, choix des outils, boucle de décision, sous-agents. Il décide combien de tokens circulent et combien d'actions sont déclenchées.
Deux mesures le rendent concret, toutes deux tirées de TraceLab (arXiv:2606.30560), agrégats sur 2 676 sessions de Claude Code. Un agent de code relit près de 280 tokens de contexte pour chaque token qu'il écrit (notre calcul sur la Table 1 : 27,3 milliards de tokens de préfixe pour 96,9 millions de tokens de sortie côté Claude). Et le pas médian d'un tel agent contient 126 180 tokens de contexte.
Ce dernier chiffre a une conséquence méthodologique directe. La seule mesure publiée du gain énergétique d'une lecture de cache a été réalisée sur un préfixe de 4 096 tokens. Transposer ce résultat à un régime trente fois plus long serait un vrai changement d'échelle, pas un détail. D'où une valeur retenue prudente.
Un surcoût n'apparaît enfin sur aucune facture : la surveillance des modèles agentiques côté fournisseur, qui mobilise du calcul d'inférence jamais facturé au client. Le prompt système, lui, est bien facturé à chaque tour, mais sa taille n'est publiée par aucun éditeur : on ne la connaît qu'en la mesurant. DONNÉE MANQUANTE sur les deux : un chiffre d'environ 20 % du calcul d'inférence circule pour la surveillance chez OpenAI, sans publication traçable derrière. Toute méthodologie doit malgré tout trancher si son facteur par token intègre cette part ou la documente à part, et écrire ce qu'elle a choisi.
Ce que ça change pour un audit
L'unité pertinente devient la tâche accomplie, plutôt que la requête ou le token. Le référentiel SCI for AI l'a d'ailleurs acté en posant l'exécution de workflow comme unité fonctionnelle de l'IA agentique.
Réclamez trois choses : le nombre de tours par session, la longueur médiane de contexte, et la ventilation des tokens entre entrée fraîche et écriture de cache d'un côté, lecture de cache et sortie de l'autre. Ces trois données suffisent à reconstruire l'essentiel de l'empreinte, et elles sont toutes dans les exports d'usage.
Sur les sessions agentiques de claude-carbon, 17,4 milliards de tokens de janvier à août 2026, la part compressible de l'empreinte, entrée fraîche et écriture de cache confondues, pèse 28,8 %. Un compresseur de prompt parfait appliqué aux seuls tokens nouveaux, sans effet sur l'historique déjà en cache, ne descendrait donc pas sous 71 % du total. Les leviers efficaces agissent sur la sortie et sur le choix du modèle.
FAQ
Un agent IA consomme-t-il vraiment des milliers de fois plus qu'une requête simple ?
C'est notre calcul sur la figure 2.1 de l'Agence internationale de l'énergie (avril 2026), entre ses deux extrêmes : 0,05 Wh pour une requête sans raisonnement, 50 Wh pour un agent qui raisonne en quatre à six appels. Sans raisonnement, l'agent de l'AIE n'est qu'à environ 23 fois. Le texte de l'AIE, lui, parle de « centaines, voire de milliers de fois » pour la vidéo, le raisonnement et les agents pris ensemble. L'étude Green IT 2025, reprise avec précaution par l'Arcep, avance de son côté un facteur 60 entre un service agentique et un service d'IA générative classique. Les deux mesurent des objets différents, et la littérature sur le sujet reste jeune.
Pourquoi le coût d'une conversation avec un agent augmente-t-il si vite ?
Parce que l'API est sans état : à chaque tour, le client renvoie l'intégralité de l'historique. Le tour numéro dix facture donc dix fois le volume d'un tour, et le cumul croît comme le carré du nombre de tours. Doubler le nombre de tours quadruple les tokens d'entrée facturés, et une conversation de 50 tours coûte 25 fois ce que coûterait un cumul linéaire.
Le cache de prompt suffit-il à régler le problème ?
Il règle le prix, en grande partie. OpenAI et Google facturent une lecture de cache environ 10 % d'un token d'entrée frais, et Anthropic 5 % sur Opus 5.5 et Sonnet 5.5, 2,5 % sur Fable 5.1 et Mythos 5.1, 10 % sur ses autres modèles (grilles au 10 octobre 2026), et des mesures sur plus de 500 sessions d'agent relèvent des baisses de coût de 41 à 80 % selon le modèle. Il ne règle ni l'occupation de la fenêtre de contexte, ni les limites de débit, et son gain énergétique exact n'a été mesuré par personne.
Combien de tokens consomme une tâche de développement automatisée ?
Pour les six modèles retenus plus haut, le classement Terminal-Bench 4.0 publie des totaux allant de 1,5 à 17,2 milliards de tokens et de 1 800 à 6 200 dollars pour passer une seule fois l'ensemble du banc d'essai, sur 66 tâches et 330 essais. À noter que l'écart de tokens entre modèles atteint un facteur 11,5 quand l'écart de coût n'est que de 3,4, et que le plus gourmand en tokens, Gemini 3.8 Flash, est le moins cher : le prix par token masque l'écart de consommation.
Quelle donnée réclamer pour chiffrer l'empreinte d'un usage agentique ?
Trois éléments, tous présents dans les exports d'usage des fournisseurs : le nombre de tours par session, la longueur médiane de contexte, et la ventilation des tokens entre entrée fraîche et écriture de cache d'un côté, lecture de cache et sortie de l'autre. Un volume global de tokens sans cette ventilation conduit à des écarts d'un facteur 3,3 à 3,6 selon le tarif appliqué aux relectures de contexte.