Le classement qui suit est ordonné par gain mesuré. Le choix de modèle arrive deuxième et pèse plus que tout ce qui le suit. L'ingénierie de prompt arrive dixième, avec un gain de 32 à 48 % d'énergie d'inférence, surtout par moins de reprises, qui ne tient qu'à une seule étude.
Deux leviers à facteur 10 peuvent donc rester intacts pendant qu'on travaille le plus faible.
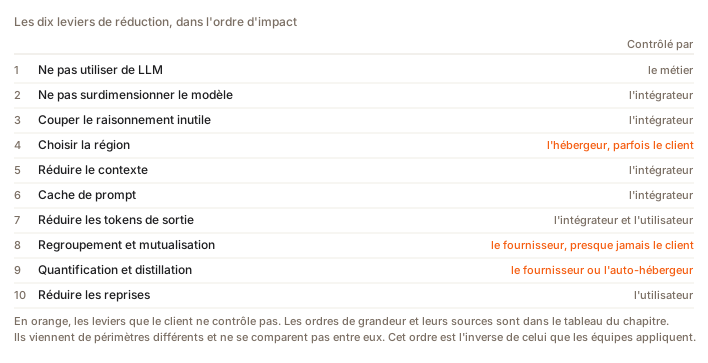
Le tableau, avec qui contrôle quoi
La dernière colonne décide de ce sur quoi on peut agir dans une mission donnée. Le chiffrage de chaque levier vient du chapitre sur la formule.
| # | Levier | Ordre de grandeur | Contrôlé par |
|---|---|---|---|
| 1 | Ne pas utiliser de LLM | le calcul n'a pas lieu | le métier |
| 2 | Ne pas surdimensionner le modèle | plus de 65 entre modèles servis par API | l'intégrateur |
| 3 | Couper le raisonnement inutile | 3 à 30, queues à 700 | l'intégrateur |
| 4 | Choisir la région | 14 à 21 sur l'intensité du réseau, 126 entre deux sites | l'hébergeur, parfois le client |
| 5 | Réduire le contexte | superlinéaire, plafond bas sur l'agentique | l'intégrateur |
| 6 | Cache de prompt | −80 % de prix, gain énergie non mesuré | l'intégrateur |
| 7 | Réduire les tokens de sortie | 48,5 % du carbone d'une session agentique | l'intégrateur et l'utilisateur |
| 8 | Regroupement et mutualisation | 17 à 25 entre un lot de 1 et un lot de 32, environ 35 entre une mesure sans regroupement et une mesure de production | le fournisseur, presque jamais le client |
| 9 | Alléger le modèle lui-même | −39 %, conditionnel | le fournisseur ou l'auto-hébergeur |
| 10 | Réduire les reprises (ingénierie de prompt) | 32 à 48 %, source unique | l'utilisateur |
Le levier transverse : mesurer, puis suivre
Aucun des dix ne se classe sans compteur. L'ordre ci-dessus vient de mesures publiées sur des modèles et des matériels donnés ; chez un client, les ordres de grandeur se déplacent selon le modèle appelé, le profil d'usage et la région. Sans mesure, on applique le classement d'un autre.
Ce qu'il faut relever :
- les trois classes de tokens séparément, entrée fraîche, lecture de cache, sortie, sinon un compteur unique surestime d'un facteur 3,3 à 3,6 sur une session d'agent ;
- le modèle appelé, requête par requête, parce que le levier 2 est le plus fort du tableau ;
- la ventilation par équipe ou par usage, sans laquelle aucun arbitrage n'a de propriétaire ;
- la date, pour que la comparaison d'un trimestre à l'autre porte sur le même périmètre.
Le suivi compte autant que la mesure initiale. Un relevé unique donne un chiffre, une série donne une tendance, et c'est la tendance qui dit si un levier a produit quelque chose. C'est aussi la seule façon de voir arriver l'effet rebond décrit plus bas.
Côté outillage, l'export d'usage d'un fournisseur d'API donne les volumes de tokens et le modèle appelé, ce qui suffit à démarrer. Pour un suivi continu par équipe, avec les trois classes de tokens et un facteur d'émission daté, c'est ce que fait TokenClimate, que je développe.
Levier 1 : ne pas utiliser de LLM
Le calcul le plus sobre est celui qui n'a pas lieu, et une bonne part des usages déployés ont un substitut déterministe moins cher, plus fiable et auditable.
Comment faisait-on avant ? Un outil existe peut-être déjà, ou un simple script, ou un tableau de bord. Ensuite, par coût croissant : la reconnaissance de caractères, des règles métier, une recherche vectorielle sans génération, un petit modèle spécialisé. Le modèle frontière vient en dernier, et seulement si aucun des précédents ne suffit.
Un repère chiffré pour situer ces solutions les unes par rapport aux autres, mesuré par Luccioni, Jernite et Strubell (Power Hungry Processing, FAccT 2024) sur une carte A100 d'un nœud de huit, sans regroupement de requêtes, en kWh pour mille inférences : classifier un texte 0,002, question-réponse extractive 0,003, générer du texte 0,047, générer une image 2,907. Générer plutôt que classifier consomme une vingtaine de fois plus d'énergie (23,5 en rapport des moyennes, environ 18 en rapport des médianes).
La première étape est une question, pas une technique : le besoin est-il vraiment de créer une fonctionnalité avec de l'IA, ou autre chose, ou rien du tout. Le premier livrable d'un cadrage sobriété est la liste des usages qui n'avaient pas besoin d'un modèle frontière.
Levier 2 : ne pas surdimensionner le modèle
L'écart entre modèles servis par API dépasse 65 entre le plus sobre (Llama-3.1-8B) et le plus gourmand (DeepSeek-R1), sur des prompts longs, parmi les 30 modèles de Jegham et al., How Hungry is AI? (v6, novembre 2025). Ces valeurs sont des estimations, pas des mesures : latence d'API plus attribution matérielle inférée. À citer avec cette limite.
Les fournisseurs le font pour eux-mêmes. Chez Google, la stratégie consiste à rediriger systématiquement les requêtes grand public vers des modèles plus petits dès qu'une nouvelle génération égale la performance de la précédente. Pour les intégrations produit, ce ne sont jamais les modèles généralistes qui tournent mais des versions spécialisées.
Trois limites, dont deux gênantes. Le verrouillage économique : les investissements dans des data centers dimensionnés pour les gros modèles incitent à les rentabiliser. Le passif d'entraînement : beaucoup de petits modèles sont distillés depuis de gros modèles, ce qui réduit leur intérêt en amont. Et un risque de superposition : si les petits modèles s'ajoutent aux gros au lieu de les remplacer, le gain s'évapore. Exigez la preuve du remplacement.
Levier 3 : couper le raisonnement inutile
Le mode raisonnement coûte +92 % d'énergie en moyenne, et jusqu'à +849 % sur une tâche de génération de code, pour un gain de performance inégal selon les tâches. Sur les tâches où il n'apporte rien, c'est un surcoût pur.
Et même là où il apporte, la moitié est superflue : une méthode publiée ramène le volume de tokens de 2 408 à 1 331 sur un jeu de mathématiques, soit −44,7 %, pour une justesse de 92,8 % contre 93,0 %.
C'est un paramètre d'API, pas un chantier. Mesurez chez le client avant de recommander un niveau : le même jeu de tâches aux différents réglages, en lisant le compteur de tokens de sortie. Une après-midi, et vous avez le seul chiffre qui compte, celui de ses tâches.
Levier 4 : choisir la région
Énergie, modèle et code identiques. Seul le mix électrique change.
Deux grandeurs différentes circulent sous le même levier, et les confondre décrédibilise l'argument.
Le rapport d'intensité entre réseaux vaut 14 chez Ember (production, ACV, 2025) et 21 chez Electricity Maps (consommation tracée, ACV, 2025) entre la France et la Pologne. C'est un facteur par kilowattheure, et il résiste au choix de base de données, ce qui est rare.
Le rapport d'inventaire annuel entre deux sites vaut 126 : Meta publie ses émissions scope 2 location-based par data center pour 2024, et l'écart entre Luleå en Suède (5 298 tCO2e) et Altoona dans l'Iowa (666 434 tCO2e) atteint ce facteur, chez le même opérateur. Ce chiffre-là agrège l'intensité du réseau et le volume d'électricité consommé sur chaque site : rapporté au kWh, l'écart tombe à environ 37, selon notre calcul. Il illustre le levier, il ne le mesure pas.
Trois limites, rarement dites.
Ce levier a un plafond d'échelle. Lin et al. (2023) relèvent que les data centers hyperscale dépassent 15 % de la charge de certains réseaux régionaux ; à cette taille, déplacer la charge vers l'électricité décarbonée perturbe le réseau qu'on cherche à ménager. Le levier marche pour un acteur isolé, pas pour tous en même temps.
Sur l'empreinte totale, ce levier rapporte moins que le rapport des réseaux : de la région AWS retenue pour Anthropic au réseau français, le composite ne baisse que d'un facteur 3,9 selon notre calcul, pas 14 ni 20, parce que le carbone du matériel ne change pas. Plus le réseau de départ est propre, plus ce plancher pèse.
Et sur une API propriétaire, vous ne choisissez pas la région. Le levier est réel pour un auto-hébergement ou un cloud avec choix de région, indisponible pour la majorité des usages.
Levier 5 : réduire le contexte
Le coût du contexte est superlinéaire, et les fournisseurs le facturent avec un multiplicateur de 2 sur l'entrée au-delà de leur palier. Router chaque question vers une recherche ciblée plutôt que vers le contexte plein réduit le volume de tokens d'entrée de 61,6 % sur Gemini 1.5 Pro, contre le contexte long complet et au prix de 3,3 points de qualité, avec une méthode hybride (Self-Route) qui repasse au contexte long quand la recherche ne suffit pas, dans Li et al. (Google DeepMind, EMNLP 2024), sur neuf jeux de données.
Le gain est en tokens, pas en joules, et le pipeline de recherche n'est pas gratuit. Et sur l'agentique, le plafond est bas : l'entrée fraîche et l'écriture de cache pèsent 28,8 % de l'empreinte, donc un compresseur parfait appliqué aux seuls tokens nouveaux, sans toucher à l'historique déjà en cache, ne descend pas sous 71 % du total.
Levier 6 : cache de prompt
Gain sans aucune perte de qualité, ce qui le rend particulier : le résultat est identique, c'est le calcul qui disparaît. Les annonces vont jusqu'à −90 % de coût sur les tokens concernés, et la mesure de Lumer et al. (Don't Break the Cache, arXiv:2601.06007, janvier 2026) sur plus de 500 sessions d'agent du banc DeepResearch Bench donne −79,6 % sur la facture complète de GPT-5.2.
Le piège de périmètre est ici. Le cache supprime le préremplissage, c'est-à-dire la partie la moins chère par token, environ 35 fois moins qu'un token de sortie à lot unitaire. Une remise de 90 % sur le prix des tokens d'entrée n'est pas 90 % d'énergie économisée.
Une seule mesure compare l'énergie d'un succès de cache à celle d'un échec, Irminsul, sur un préfixe de 4 096 tokens, loin des contextes d'un agent. Position tenable : le cache réduit le calcul réellement effectué sans dégrader la sortie, son ampleur énergétique à l'échelle d'un agent n'est pas mesurée, et elle est inférieure à la remise commerciale.
Le cache est un préfixe : tout ce qui modifie le début du contexte en cours de session l'invalide pour la suite, donc ne rien ajouter en route. Le compteur de durée démarre au début de la requête, pas à la fin de la réponse. Et les modèles économiques diffèrent, l'un facturant l'écriture, l'autre le stockage horaire.
Le décodage spéculatif, même famille, même piège
Un petit modèle « brouillon » propose plusieurs tokens d'avance, le gros modèle les vérifie en une seule passe et garde le plus long début compatible avec ce qu'il aurait produit lui-même.
Même propriété que le cache : à température nulle, quand le modèle prend toujours le token le plus probable, la sortie est strictement identique. Ce n'est pas une approximation, c'est une réorganisation du calcul. Les accélérations publiées vont de 2 à 3,6 fois, toutes mesurées en latence : 2 à 3 fois chez Leviathan, Kalman et Matias (arXiv:2211.17192, ICML 2023) sur T5-XXL à lot unitaire, jusqu'à 3,6 fois pour Medusa (arXiv:2401.10774).
Le piège est plus vicieux que celui du cache, parce qu'il peut inverser le gain. Les deux seules mesures énergétiques publiées donnent −12 % à −27 % avec un brouillon bien apparié (Nik, Riegler et Halvorsen, SimulaMet, arXiv:2502.11723, version revue Scientific Reports 2026 ; Qwen2.5-7B sur A100, brouillon n-gram, décodage glouton), et +30 % de consommation malgré une accélération de 1,19 fois quand le brouillon est mal apparié (Dutta et al., arXiv:2602.09113, Findings of EACL 2026 ; Vicuna-7B sur A5000, mesure CodeCarbon). Les deux tournent à lot unitaire, le régime le plus favorable.
Vitesse et énergie ne vont donc pas forcément dans le même sens. Comme le regroupement, ce levier appartient au fournisseur.
Levier 7 : réduire les tokens de sortie
Un token de sortie consomme environ 35 fois l'énergie d'un token d'entrée, mesuré à lot unitaire. Sur une session agentique, la sortie représente 0,73 % du volume et 48,5 % du carbone.
Trois façons d'agir : contraindre la longueur de réponse et couper le raisonnement, mais aussi choisir un modèle qui répond court. Ce dernier point est mal connu : à tâche identique, les modèles produisent des réponses de longueurs différentes, et cette verbosité n'apparaît dans aucune grille de comparaison.
Un piège à connaître. Optimiser les joules par token incite à générer plus, puisque les coûts fixes s'amortissent : Vellaisamy et al. (Carnegie Mellon) mesurent sur Qwen3-8B et MATH-500, sur un H200, 7,46 J par token à 10 tokens de sortie contre 0,72 J à 512, alors que l'énergie de la requête est multipliée par 5. Optimisez les joules par tâche résolue.
Levier 8 : regroupement et mutualisation
Le décodage est limité par la mémoire, donc traiter plusieurs requêtes dans la même passe amortit la lecture des poids. Deux grandeurs distinctes, qu'il faut donner séparément.
Le gain va de 17 à 25 entre un lot de 1 et un lot de 32, selon l'architecture d'attention (Ma et al., The Illusion of Power Capping in LLM Decode, mai 2026 ; un H200, modèles d'environ 4 milliards de paramètres, phase de décodage isolée).
L'écart total observable entre une mesure sans regroupement et une mesure de production atteint environ 35 sur des modèles de même classe. Celui-là compare deux protocoles complets, pas deux tailles de lot : 1,72 Wh par requête sur Llama-3-70B chez AI Energy Score contre 0,0486 Wh sur Llama 3.3 70B chez ML.Energy v3.0. Les poids ne sont pas exactement les mêmes, l'ordre de grandeur tient.
D'où une conclusion contre-intuitive : auto-héberger un modèle à faible volume est énergétiquement pire qu'appeler une API mutualisée. Les chiffres : en génération, un H200 ne tire que 137 à 300 W sur 700, de lot 1 à lot 32, l'énergie par token à lot unitaire est 17 à 25 fois celle du lot de 32, et sur BLOOM, mesuré 18 jours sur 16 A100 sans regroupement, environ 75 % de l'énergie sert simplement à maintenir le modèle en mémoire (Luccioni, Viguier et Ligozat, JMLR 2023).
Deux nuances, sinon vous vendez du cloud. D'abord, distinguez cet argument physique de l'argument marketing des hyperscalers, qui comparent leur flotte à une installation délibérément inefficace. Et à volume élevé et charge régulière, l'auto-hébergement redevient défendable, avec des leviers que l'API interdit. Le seuil se calcule.
Levier 9 : alléger le modèle lui-même
Deux techniques, appliquées au modèle et pas à la façon de l'appeler. La quantification réduit la précision des nombres qu'il manipule. La distillation entraîne un petit modèle à imiter un gros. Dans les deux cas le modèle qui tourne est plus léger que celui d'origine.
Réduire la précision numérique à 8 bits fait gagner 39 % en moyenne selon l'estimation du PEReN pour l'Arcep (mai 2026, 22 modèles ouverts sur le supercalculateur Jean Zay, GPU seul). Et la distillation de 83 à 90 % d'énergie d'inférence pour 13 à 15 points de ROUGE-L en moins, sur CodeT5+ et une RTX 4090 (arXiv:2608.17515).
Le résultat qui empêche de le recommander à l'aveugle : à petit lot, entre 8 et 16 requêtes, la précision réduite consomme plus que la précision standard dans 7 cas mesurés sur 7, avec une médiane à +30 % (ML.Energy v3.0, observation 7, H100 et B200). Le gain n'apparaît qu'à gros lot. La basse précision ne rapporte que dans les régimes limités par le calcul ; en régime limité par la mémoire, elle ne rapporte rien.
Sur la qualité, ne reprenez pas les « dégradation négligeable » des papiers de méthode. La source la plus honnête est celle de Meta, qui écrit que les benchmarks standards ne reflètent pas correctement les effets de la quantification, et que sans garde-fous le modèle produit occasionnellement des réponses corrompues alors que les scores restent bons.
Levier 10 : réduire les reprises
Une réponse ratée est de l'énergie dépensée pour rien, plus une seconde requête. Sur une conversation, la reprise coûte davantage que la requête initiale, puisque tout l'historique est renvoyé.
L'ingénierie de prompt, c'est aussi de l'énergie économisée, au sens propre : un prompt qui obtient le bon résultat du premier coup supprime des requêtes entières. Un travail de green prompting, Podder, Date et Murthy (Environmental Science and Ecotechnology, mars 2026), mesure 32 à 48 % d'énergie d'inférence en moins quand ses bonnes pratiques de prompt sont appliquées, sur plusieurs modèles et scénarios. Le rapport Arcep de mai 2026 écrit, lui, « jusqu'à 50 % », en citant l'Unesco (2025). Une seule étude derrière le chiffre.
Les gestes qui marchent. Cadrez une fois plutôt que dix allers-retours : un prompt plus long mais précis coûte moins cher qu'un prompt court qui force l'itération, puisque l'entrée consomme 35 fois moins d'énergie que la sortie à lot unitaire, et coûte environ 5 fois moins cher. Écrivez chaque prompt comme si vous n'aviez qu'une chance, et envoyez du texte plutôt qu'un document scanné. Dernier point, ne remplissez pas la fenêtre à ras bord : la qualité se dégrade bien avant la limite technique, donc les reprises augmentent. DONNÉE MANQUANTE sur le seuil : aucune mesure publiée ne relie taux de remplissage et taux d'erreur. Il faudrait faire tourner une même évaluation à plusieurs taux de remplissage, à modèle et tâche constants.
La limite qu'il faut poser, sinon ce levier devient une manipulation : sa valeur réelle est pédagogique, il rend le sujet tangible pour un utilisateur qui ne choisit ni son modèle ni sa région. Son risque est de déplacer la responsabilité sur l'utilisateur final pendant que les décisions à facteur 10 se prennent ailleurs. Le mettre en dixième position n'est pas un hasard, et il faut le dire à voix haute en le présentant.
Question
Un client veut réduire l'empreinte de son assistant interne et vous donne une seule journée. Par quoi commencez-vous ?
Choisissez une réponse pour voir l'explication.
Le levier qui n'en est pas un
La température règle le tirage du token suivant (chapitre 1) : basse, le modèle prend presque toujours le token le plus probable ; haute, ses réponses varient davantage. Un modèle plus prévisible donne l'impression de travailler moins, d'où l'idée de baisser la température pour consommer moins. Ça ne marche pas.
Techniquement, la température est une division des scores, appliquée après tout le calcul, sur un vecteur de la taille du vocabulaire. Elle n'ajoute ni couche, ni passe, ni lecture de poids. Son coût est négligeable devant le reste.
La mesure confirme : Nik, Riegler et Halvorsen (SimulaMet, arXiv:2502.11723, version revue Scientific Reports 2026) balaient la température de 0,1 à 1,2 sur Qwen2.5-7B, deux A100-PCIE-40GB, lot unitaire, et trouvent un écart de −0,2 % à +2,6 % avec le décodage glouton selon la tâche. Du bruit. Dans les mêmes conditions, passer à la stratégie de décodage DoLa coûte 51,5 % de plus.
Deux canaux indirects existent quand même. Une température haute peut faire écrire plus longtemps, et le coût est alors dans le nombre de tokens, pas dans le réglage. Elle dégrade aussi le taux d'acceptation du décodage spéculatif : EAGLE-2 (arXiv:2406.16858) mesure une perte d'accélération de 5,4 à 21,6 % en passant de la température nulle à 1, sur les paires mal appariées seulement. Le chaînage vers l'énergie n'a été mesuré par personne.
Personne n'a mesuré la longueur moyenne de sortie en fonction de la température à modèle et prompt fixés. DONNÉE MANQUANTE. L'expérience tient en deux jours pour qui a un GPU : longueur de sortie et fréquence à laquelle le modèle s'arrête de lui-même, à plusieurs températures, sur un jeu de prompts fixe.
Ce que cette liste ne règle pas
L'efficacité par processus n'indique pas la consommation du système. Google a divisé par 33 l'énergie de sa requête médiane entre mai 2024 et mai 2025. Sur l'année 2025, la consommation électrique de ses data centers a augmenté de 38 % et ses émissions totales, dans son périmètre « ambition-based », de 18 %. Les dix leviers ci-dessus sont réels et chiffrés, et ils ont tous été activés à grande échelle par les acteurs qui les maîtrisent le mieux.
Si elle reste au volontariat, la sobriété de l'un libère de la capacité pour un autre. Seule une contrainte sur le total, un plafond ou un budget opposable, compense un effet rebond.
Les leviers individuels existent et sont chiffrés, mais à eux seuls ils ne font pas baisser le total.
Pour appliquer ce classement à un usage réel, le calculateur chiffre un mix de modèles et la méthodologie publie les paramètres utilisés.
FAQ
Quel est le levier le plus efficace pour réduire l'empreinte de l'IA ?
Ne pas utiliser de modèle de langage quand un substitut déterministe suffit, puisque le calcul n'a alors pas lieu. Le choix de modèle vient juste après, avec un écart de plus de 65 entre le modèle le plus sobre et le plus gourmand, estimé par Jegham et al. sur 30 modèles servis par API, sur des prompts longs. L'optimisation des prompts arrive en dixième position, avec un gain qui ne repose que sur une étude.
Optimiser ses prompts réduit-il vraiment l'empreinte carbone ?
Oui, sur les échanges qui forçaient des reprises, mais la preuve est mince. Podder, Date et Murthy (2026) mesurent 32 à 48 % d'énergie d'inférence en moins quand leurs bonnes pratiques de prompt sont appliquées, surtout parce qu'elles évitent de recommencer. Le rapport Arcep de mai 2026 écrit « jusqu'à 50 % » en citant l'Unesco. Une seule mesure publiée, et un gain limité aux tâches où l'on recommençait. Sa valeur réelle est pédagogique : il rend le sujet tangible pour un utilisateur qui ne contrôle rien d'autre.
Faut-il auto-héberger un modèle pour réduire son empreinte ?
Pas à faible volume, où c'est énergétiquement pire qu'une API mutualisée. En génération, un H200 ne tire que 137 à 300 W sur un budget de 700, même en regroupant jusqu'à 32 requêtes, et à requête unique plus de 88 % de ses cœurs tenseurs restent inactifs, tandis qu'environ 75 % de l'énergie sert à maintenir le modèle chargé. À volume élevé et charge régulière, l'arbitrage s'inverse.
Couper le mode raisonnement dégrade-t-il la qualité ?
Sur les tâches qui ne le justifient pas, non : l'étude du PEReN pour l'Arcep estime un surcoût moyen de 92 % d'énergie, avec un intervalle large, pour un gain de performance inégal selon les tâches. Et même là où il apporte, une méthode publiée supprime 44,7 % des tokens de raisonnement pour une perte de justesse de 0,2 point. Le réglage doit s'appuyer sur une évaluation, pas sur une intuition.
Les gains d'efficacité suffisent-ils à faire baisser l'empreinte totale de l'IA ?
Non, et le meilleur contre-exemple vient d'un fournisseur. Google a divisé par 33 l'énergie de sa requête médiane entre mai 2024 et mai 2025, pendant que, sur l'année 2025, la consommation électrique de ses data centers augmentait de 38 % et ses émissions totales de 18 % dans le périmètre « ambition-based » de son 2026 Environmental Report. Seule une contrainte sur le volume total, sous forme de plafond ou de budget, compense un effet rebond.